Kai 1: Entscheidungen, keine Vervollständigungen
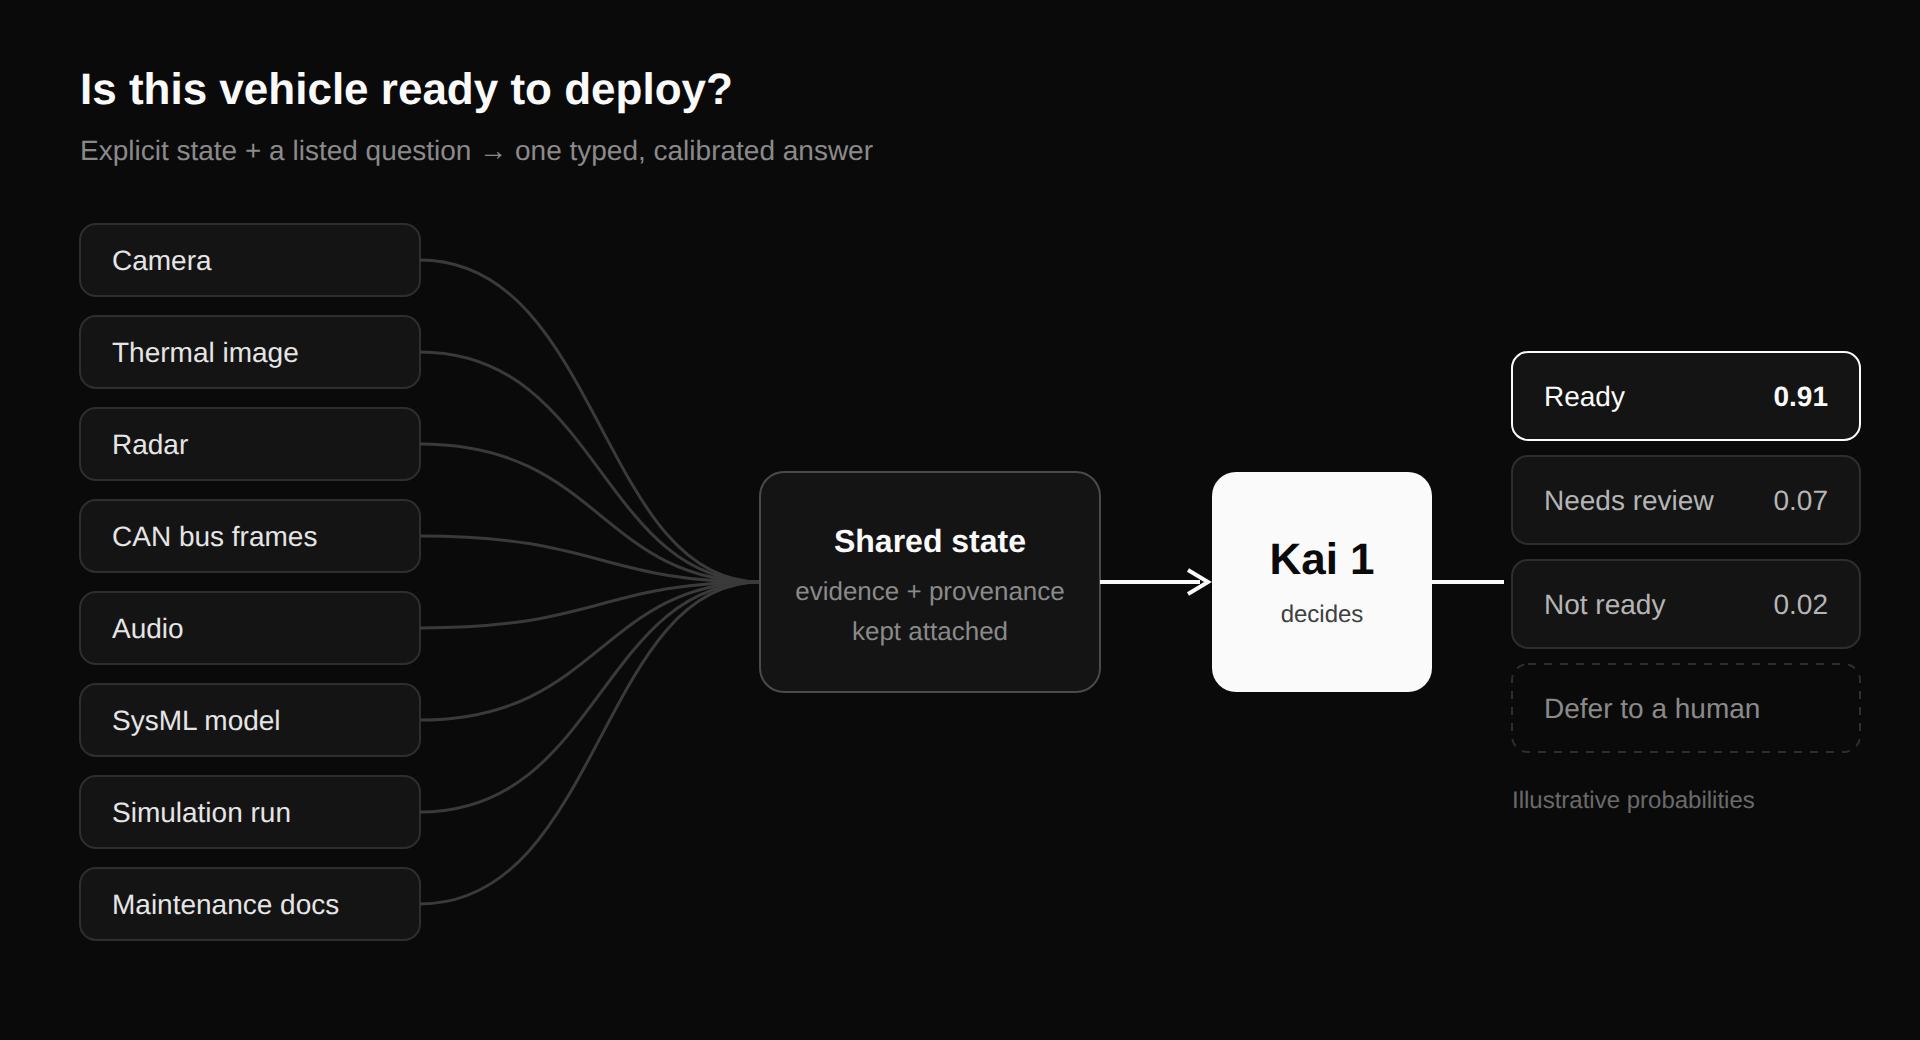
Kai ist das Entscheidungsmodell von Hanzo und wird über die Hanzo API bereitgestellt. Übergeben Sie einen expliziten Zustand und eine Frage mit aufgeführten Optionen, und es liefert eine typisierte, kalibrierte Antwort: eine Auswahl, eine Bewertung, ein Ja oder Nein oder eine begründete Zurückstellung.
Auf dieser Seite
Die meisten Schritte in Produktivsoftware brauchen keinen Absatz. Sie brauchen eine Antwort, mit der die Software handeln kann: welches Werkzeug aufzurufen ist, ob die Evidenz reicht, wie schwer ein Risiko wiegt und ob ein Mensch freigeben muss.
Heute stellen wir Kai 1 vor, das Entscheidungsmodell von Hanzo. Geben Sie Kai die Fakten einer Lage und eine Frage mit aufgeführten Optionen. Es liefert eine typisierte Antwort (eine Auswahl, eine Bewertung, ein Ja oder Nein oder ein kalibriertes «nicht sicher, zurückstellen») mit einer Wahrscheinlichkeit für jede Option.
Kai 1 ist auf der Hanzo API verfügbar. Die Gewichte sind geschlossen: Kai gibt es nur über die API.

Sprachmodelle schlussfolgern. Kai entscheidet.
Wenn Sie ein Sprachmodell um eine Entscheidung bitten, bekommen Sie Text zurück. Sie müssen ihn auswerten, einer Konfidenzzahl vertrauen, die das Modell erfunden hat, und hoffen, dass die Ausgabe im Rahmen bleibt.
Kai ist für die Schritte gebaut, an denen das nicht reicht. Seine Antworten sind begrenzt, seine Wahrscheinlichkeiten sind kalibriert, und es gibt nichts auszuwerten. Jede Antwort von Kai gehört zu einem von vier Typen:
- Auswahl: eine Option aus einer aufgeführten Menge, mit einer Wahrscheinlichkeit für jede
- Bewertung: eine Einstufung nach Stufen, die Sie festlegen
- Prädikat: ein Ja oder Nein mit seiner Wahrscheinlichkeit
- Zurückstellen: Kai ist nicht sicher genug und gibt die Entscheidung an eine Person oder eine Regel ab
Die Evidenz bleibt verknüpft
Eine Entscheidung sollte nicht davon abhängen, ob ihre Evidenz als Text, Bild oder Sensormessung begann. Kai ist dafür ausgelegt, gemischte Evidenz aufzunehmen und ihre Herkunft an jede Antwort zu binden.
Eine Zahl ohne Herkunft ist bloß eine Zahl.

Viele Entscheidungen, ein Durchlauf
Agentenschleifen stellen eine Frage nach der anderen. Kai ist dafür ausgelegt, ein ganzes Entscheidungsprogramm auf einmal auszuführen: ein gemeinsamer Zustand, viele Entscheidungen, mit ausformulierten Abhängigkeiten. Sichere Antworten werden zuerst festgeschrieben, und nur die unsicheren bekommen weitere Arbeit.
Ein Programm mit Tausenden von Entscheidungen soll nicht Tausende Modellaufrufe hintereinander brauchen.

Jede Entscheidung lässt sich erneut abspielen
Jede Entscheidung von Kai zeichnet die Programmversion, die Fingerabdrücke der Evidenz, die Modellrevision, die volle Wahrscheinlichkeitsverteilung, die Freigaben und die Ausführungsspur auf. Wenn jemand fragt, warum das System etwas getan hat, können Sie es zeigen.

Wo Kai hinpasst
- Agenten: Modell- und Werkzeugwahl, wann weiter oder Stopp, wann ein Mensch gefragt wird
- Geschäftsabläufe: Lead-Bewertung, Absichtserkennung, nächste beste Aktion, Eskalation
- Physische Systeme: Fahrzeuge, Robotik, Fertigung, Energie und Infrastruktur, wo Entscheidungen auf Sensordaten laufen
Teil des Hanzo-Stacks

Erzeugen und Entscheiden sind verschiedene Aufgaben. Zen6 ist unsere Familie von Generierungsmodellen mit offenen Gewichten. Kai 1 trifft begrenzte, kalibrierte Entscheidungen. Enso lenkt jede Aufgabe an das Modell, das sie braucht.
Wo es läuft
Kai läuft auf der Hanzo API, unter POST https://api.hanzo.ai/v1/decisions, für $0.021 pro Million Eingabetoken; Ausgabetoken sind kostenlos. Die Gewichte sind nicht veröffentlicht, und ein Selbsthosting wird nicht angeboten.
Wie es weitergeht
Wir arbeiten an sieben offenen Forschungsfragen und veröffentlichen Ergebnisse erst, wenn sie sich reproduzieren lassen:
- Entscheidungen über extrem große Optionsmengen
- Mehrsprachige Entscheidungen
- Dekodierung mit gemeinsamem Zustand
- Entscheidungsdiffusion (nur unsichere Antworten nachschärfen)
- Multimodale Evidenz
- Kalibrierung und das Wissen, wann Enthaltung angebracht ist
- Konsistenz über verbundene Entscheidungen
Die ersten Ergebnisse von Kai 1 sind veröffentlicht. Auf den 12 wichtigsten Suiten eines eingefrorenen Entscheidungs-Prüfstands erreicht Kai 1 im Schnitt 85.7% Genauigkeit, gegenüber 78.0% bei Jev. Es ist auf 11 von 12 Suiten genauer, liegt beim Jailbreak zurück (91.75% gegenüber 94.0%), und der Kalibrierungsfehler ist auf 8 von 12 niedriger. Diese Läufe wurden auf CUDA gemessen; Produktivantworten laufen auf CPU. Kai 1 ist noch nicht wettbewerbsfähig bei abhängigen Programmen mit mehreren Fragen, bei verneinten Ja/Nein-Fragen, ab 150 Optionen oder bei der Kalibrierung typisierter Entscheidungen und von Jailbreak, und ab 1,000 Optionen liegt die Genauigkeit nahe null. Jede Tabelle, mit dem Lauf, aus dem jede Zahl stammt: hanzo.ai/kai und die Kai-Dokumentation.
Hören Sie auf, von einem Modell alles zu verlangen
Rufen Sie Kai noch heute über die Hanzo API auf.
Weiterlesen
Was ist ein Entscheidungsmodell?
Generative Modelle schlussfolgern in unbeschränkten Absätzen. Entscheidungsmodelle entscheiden in typisierten, kalibrierten Zustandsübergängen. Darum liegt die nächste Grenze der KI nicht in der Erzeugung, sondern in Entscheidungen.
Headless Commerce für agentische LLMs lesbar und zahlbar machen
Käufer werden zu Agenten. Was es braucht, damit ein LLM lesen, unterschreiben und bezahlen kann, ohne dass ein Mensch eingreift, und was Hanzo dafür heute liefert.
Ihre KI plant, Sie zu töten
Warum Frontier-Modelle versagen, wenn echte Menschenleben auf dem Spiel stehen, und wie Hanzo Kai 1.9 deterministische Sicherheit durchsetzt.