¿Qué es un modelo de decisión?
Los modelos generativos razonan en párrafos sin coto. Los modelos de decisión deciden en transiciones de estado tipadas y calibradas. He aquí por qué la próxima frontera de la IA no es la generación, sino las decisiones.
En esta página
Durante tres años, la industria de la IA ha tratado cada problema de cómputo como un problema de generación de texto.
Cuando un agente autónomo tiene que elegir una herramienta, verificar una transacción financiera, clasificar una vulnerabilidad de seguridad, ajustar un actuador robótico o determinar si una acción exige aprobación humana, el estándar del sector ha sido consultar un modelo de lenguaje de 70 mil millones de parámetros y esperar a que genere un flujo abierto de tokens. Después, los desarrolladores despliegan patrones regex frágiles, analizadores JSON especulativos y bucles de reintento para extraer una sola palabra o un valor booleano de la respuesta.
Ese enfoque no es solo un desperdicio de cómputo: gasta cientos de pasos de decodificación autorregresiva en serie para obtener una salida que cabría en dos bits. Es, de raíz, un desajuste de arquitectura.
Los modelos de lenguaje generativos se entrenaron para maximizar la verosimilitud del token siguiente sobre una distribución textual infinita. Son discursivos, conversacionales y, por su estructura, propensos a alucinar cuando hay incertidumbre. Pero el 95% del flujo de control en los sistemas de software no necesita un ensayo.
Necesita una decisión.
Los modelos de lenguaje razonan. Los modelos de decisión deciden.
Para entender la diferencia, conviene mirar las funciones objetivo que hay debajo.
Un modelo de lenguaje de gran tamaño (LLM) optimiza la verosimilitud autorregresiva de los tokens sobre una secuencia abierta:
Loss_LLM = - Σ log P(w_t | w_<t)Genera una secuencia de tokens w_1, w_2, ..., w_n muestreada de un vocabulario sin coto de más de 100,000 posibilidades. El modelo no puede declarar que le falta evidencia para responder sin generar frases de lenguaje natural que imitan la modestia; no puede emitir una distribución de probabilidad nativa sobre un espacio de estados operativo; y las cifras de confianza que declara él mismo son notoriamente poco calibradas.
Un modelo de decisión optimiza un objetivo radicalmente distinto. Dado un estado de evidencia explícito E y un espacio de decisión estructurado D, un modelo de decisión calcula una proyección directa hacia una salida acotada y tipada y:
y_hat = argmax_y P(y | E, D)Dotado de una distribución a posteriori estrictamente calibrada P(y | E) y de una primitiva operativa de primera clase para la abstención fundamentada (DEFER).
| Dimensión arquitectónica | Modelos de lenguaje generativos (LLM) | Modelos de decisión (p. ej., Hanzo Kai) |
|---|---|---|
| Objetivo principal | Síntesis y generación de texto abierto | Transiciones de estado discretas y verificables |
| Espacio de salida | Secuencias de tokens sin coto (vocabulario de 100k+) | Esquemas acotados y estrictamente tipados (Choice, Score, Predicate, Defer) |
| Confianza y calibración | Sin calibrar; softmax confabulada sobre los tokens | Probabilidades calibradas de forma empírica (P = 0.90 implica una exactitud del 90%) |
| Representación del estado | Ventana de contexto efímera hecha de cadenas de tokens | Plano de evidencia multimodal estructurado, con procedencia criptográfica |
| Topología de ejecución | Decodificación autorregresiva en serie (latencia O(N)) | Resolución de grafos en paralelo y difusión de decisiones (pase hacia adelante O(1)) |
| Tratamiento de la incertidumbre | Alucina completaciones verosímiles | Abstención fundamentada (DEFER ante una política o un revisor humano) |
| Auditabilidad | Explicaciones verbales no deterministas | Paquetes de decisión inmutables y reproducibles, con pruebas de hash criptográfico |
Cuando separáis el razonamiento de la decisión, la arquitectura del sistema se vuelve órdenes de magnitud más simple, más rápida y más fiable.
Los cinco pilares arquitectónicos de un modelo de decisión
Un modelo de decisión de verdad no es un LLM al que se le pide «Responde con JSON válido». Es una arquitectura neuronal dedicada, diseñada desde la base para la evaluación acotada. El modelo de decisión de pesos abiertos de Hanzo, Kai 1, se apoya en cinco pilares arquitectónicos:
1. Salidas acotadas y tipadas (cero análisis de cadenas)
En el software de producción, toda interfaz entre sistemas ha de estar estrictamente tipada. Pedirle a un modelo de lenguaje que produzca una decisión y confiar en que respete un esquema regex introduce un riesgo de cola catastrófico.
Los modelos de decisión eliminan por completo el análisis de texto. Cada salida se tipa de forma nativa en una de cuatro primitivas:
Choice<T>: una selección dentro de un conjunto explícito y enumerado de candidatos, acompañada de la distribución de probabilidad completa sobre todas las alternativas (p_1, p_2, ..., p_k, dondeΣ p_i = 1.0).Score[min, max]: una valoración cuantitativa acotada dentro de límites operativos fijos, con sus intervalos de confianza.Predicate: una verificación booleana pura (trueofalse) con certeza calibrada.Defer: una negativa explícita a adivinar cuando la evidencia es insuficiente o contradictoria, de modo que la ejecución pasa a una política de respaldo ya definida o a una persona en el bucle.
Como la capa de salida queda restringida al esquema válido en el nivel de los logits, un modelo de decisión no puede, físicamente, producir un resultado fuera de límites, un valor de enumeración ilegal o una carga mal formada.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. El plano de evidencia multimodal unificado
Las decisiones del mundo real rara vez dependen solo del texto. En dominios críticos —finanzas soberanas, manipulación robótica, triaje médico automatizado y telemetría industrial— hay que evaluar señales heterogéneas a la vez.
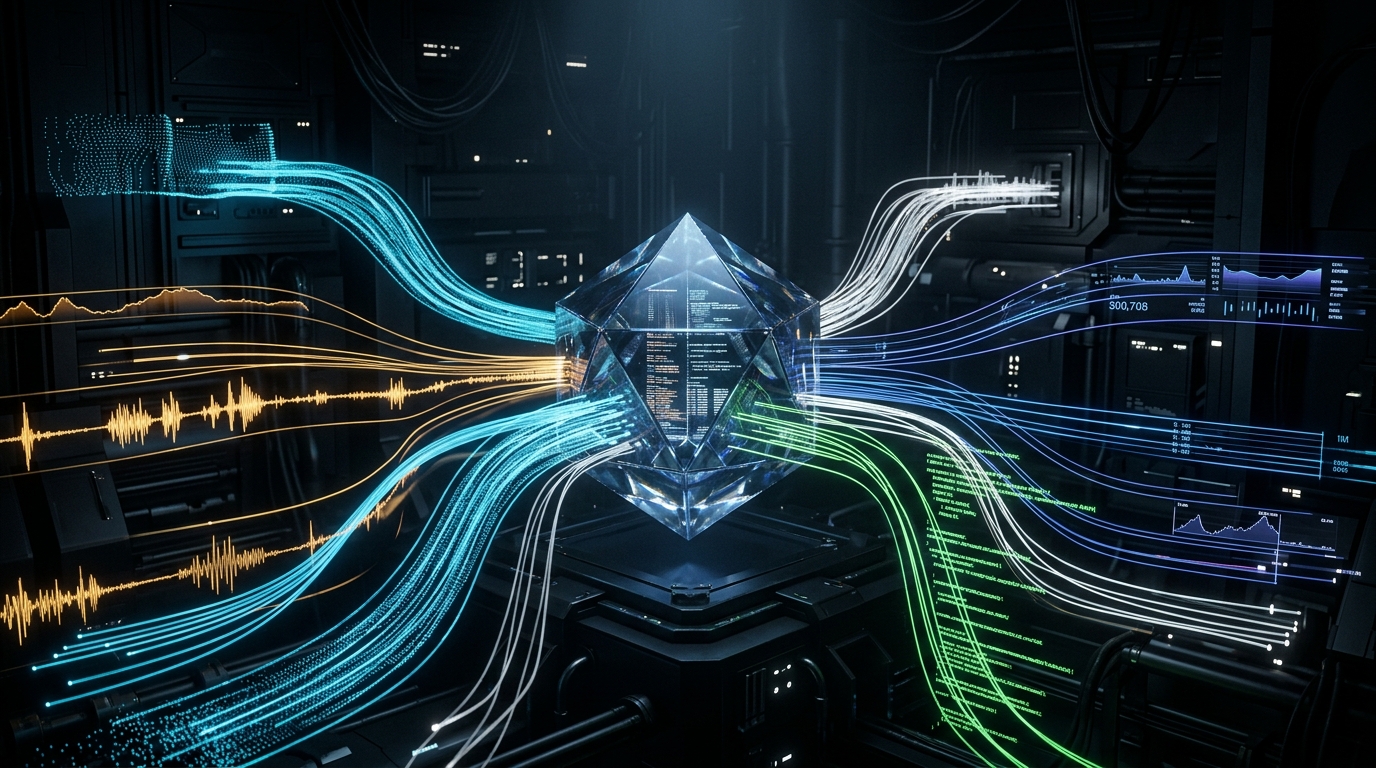
Un modelo de decisión no serializa datos tabulares, lecturas de sensores y matrices de radar en tablas Markdown torpes para que un LLM las lea. En su lugar, Kai emplea codificadores de modalidad especializados:
- Telemetría y series temporales: ventanas deslizantes vectorizadas y rasgos del dominio de la frecuencia.
- Visual y térmica: tokens visuales densos procedentes de redes troncales de visión.
- Estado estructurado: proyecciones de entidades en grafo y relacionales, tomadas del Hanzo Datastore.
- Código y especificaciones: incrustaciones semánticas a nivel de AST y matrices de requisitos formales.
Todas las modalidades se proyectan en un plano de evidencia unificado. Y, sobre todo, la evidencia conserva la procedencia criptográfica: cada tensor de entrada se hashea y se le toma la huella. Si una decisión se audita seis meses después, el estado exacto de la entrada puede reconstruirse bit a bit.
3. Resolución de grafos en paralelo y difusión de decisiones
El mayor cuello de botella de los agentes autónomos modernos es la ejecución en serie. Un bucle de agente que exige 50 decisiones intermedias suele llamar a un LLM 50 veces, una tras otra. A entre 500ms y 2s por completación, el agente se pasa minutos solo recorriendo su propio flujo de control.
Además, la propagación de errores en las cadenas seriales de LLM es catastrófica. Si cada paso tiene una tasa de acierto del 95%, una cadena de 20 pasos solo tiene éxito en:
0.95 ^ 20 ≈ 35.8%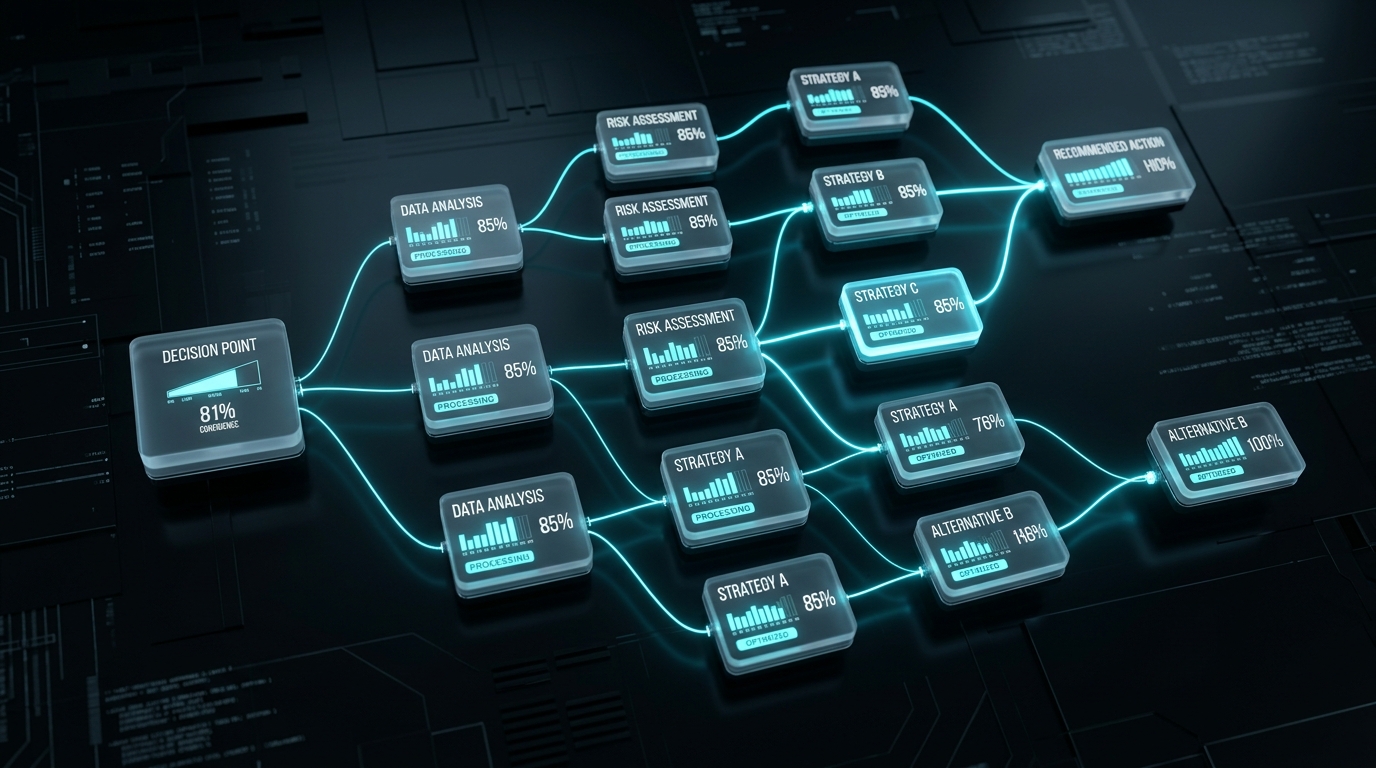
Los modelos de decisión resuelven esto mediante la difusión de decisiones sobre grafos acíclicos dirigidos (DAG).
En lugar de evaluar las decisiones en serie, el programa de decisión entero se envía de una vez. En un solo pase hacia adelante:
- Pase 1 (convergencia inmediata): el 80–90% de los nodos con evidencia inequívoca se resuelve al instante, con alta confianza (
P > 0.99). - Pase 2 (difusión condicional): los nodos dependientes reciben los estados ya fijados de sus padres y refinan sus distribuciones de probabilidad.
- Pase 3 (satisfacción de restricciones): los nodos que siguen con alta entropía o en conflicto se evalúan frente a restricciones de frontera formales.
Un flujo de trabajo complejo, con 100 decisiones operativas interdependientes, se resuelve en milisegundos, no en minutos.
4. Calibración rigurosa y abstención fundamentada
Si un modelo de IA os dice que tiene un 99% de confianza, ¿con qué frecuencia acierta de verdad?
En los modelos generativos de catálogo, la confianza que declaran ellos mismos correlaciona notoriamente mal con la verdad. Sufren una sobreconfianza grave ante entradas fuera de distribución y alucinan, sin reparo, justificaciones convincentes de salidas erróneas.
En aplicaciones industriales, aeroespaciales y financieras, una respuesta errónea y demasiado segura es fatal. Un modelo de decisión ha de estar calibrado de forma empírica:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pCuando Kai emite una probabilidad de 0.85, esa decisión es empíricamente correcta exactamente el 85% de las veces.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Cuando la entropía supera una tolerancia al riesgo parametrizada τ, el modelo no adivina. Invoca la abstención fundamentada:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFEREl sistema devuelve la ejecución a especialistas humanos o a reglamentos deterministas, y aporta un gradiente de sensibilidad explícito que señala qué pieza de evidencia ausente reduciría más la entropía.
5. Paquetes de decisión reproducibles (la pista de auditoría)
En los entornos empresariales regulados, «la IA generó este texto» no es una defensa legal válida ni una postura de cumplimiento.
Cada decisión que evalúa Kai produce un paquete de decisión inmutable y sellado criptográficamente:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Si un auditor o un ingeniero de respuesta a incidentes consulta una transacción años después, puede reproducir el paquete de decisión contra la revisión exacta del modelo y comprobar que la salida fue matemáticamente determinista, a prueba de manipulación y conforme a la política.
Dónde encajan los modelos de decisión en vuestra pila
Los modelos de decisión no sustituyen a los modelos generativos. Liberan a los modelos generativos de los trabajos para los que nunca se diseñaron.
En las arquitecturas empresariales modernas, los sistemas funcionan cuando las tareas se separan con limpieza entre generación y control:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: los modelos generativos de frontera de Hanzo, hechos para razonar. Usad Zen cuando necesitéis investigación textual profunda, pruebas de cadena de pensamiento de varios pasos, síntesis creativa y redacción de documentos.
- Kai: la familia de modelos de decisión de pesos abiertos de Hanzo. Usad Kai cuando necesitéis enrutado determinista, selección de herramientas, umbrales de seguridad, ejecución de operaciones, triaje y control del bucle del agente.
- Enso: el metaenrutador de alto rendimiento que inspecciona las tareas entrantes en la capa de los microsegundos, envía las tareas generativas a Zen y las de decisión a Kai.
Pesos abiertos. Infraestructura soberana.
Una infraestructura de decisión fiable no puede quedar encerrada en una API cerrada de terceros que cambia de comportamiento sin aviso. Cuando un modelo gobierna despliegues de producción, sistemas físicos o riesgo financiero, tenéis que tener soberanía completa sobre sus pesos, su tiempo de ejecución y la privacidad de los datos.
Kai 1 tiene los pesos abiertos. Podéis ejecutarlo:
- En la nube soberana de Hanzo: a escala global, con garantías de egress cero y latencias por debajo del milisegundo.
- En vuestra propia VPC o en local: desplegable con Docker o Kubernetes, en GPU NVIDIA, AMD ROCm o nodos de CPU de alta densidad.
- En el extremo: totalmente desconectado, para robótica, aeroespacial y entornos de defensa soberana.
Dejad de pedir a los modelos de lenguaje que escriban ensayos cuando vuestro software solo necesita una decisión.
Bienvenidos a la era de la inteligencia de decisión.
Decisiones, no completaciones
Ejecutad Kai hoy a través de la Hanzo Cloud API, o descargad los pesos abiertos para desplegar modelos de decisión calibrados dentro de vuestra infraestructura soberana.
Leer más
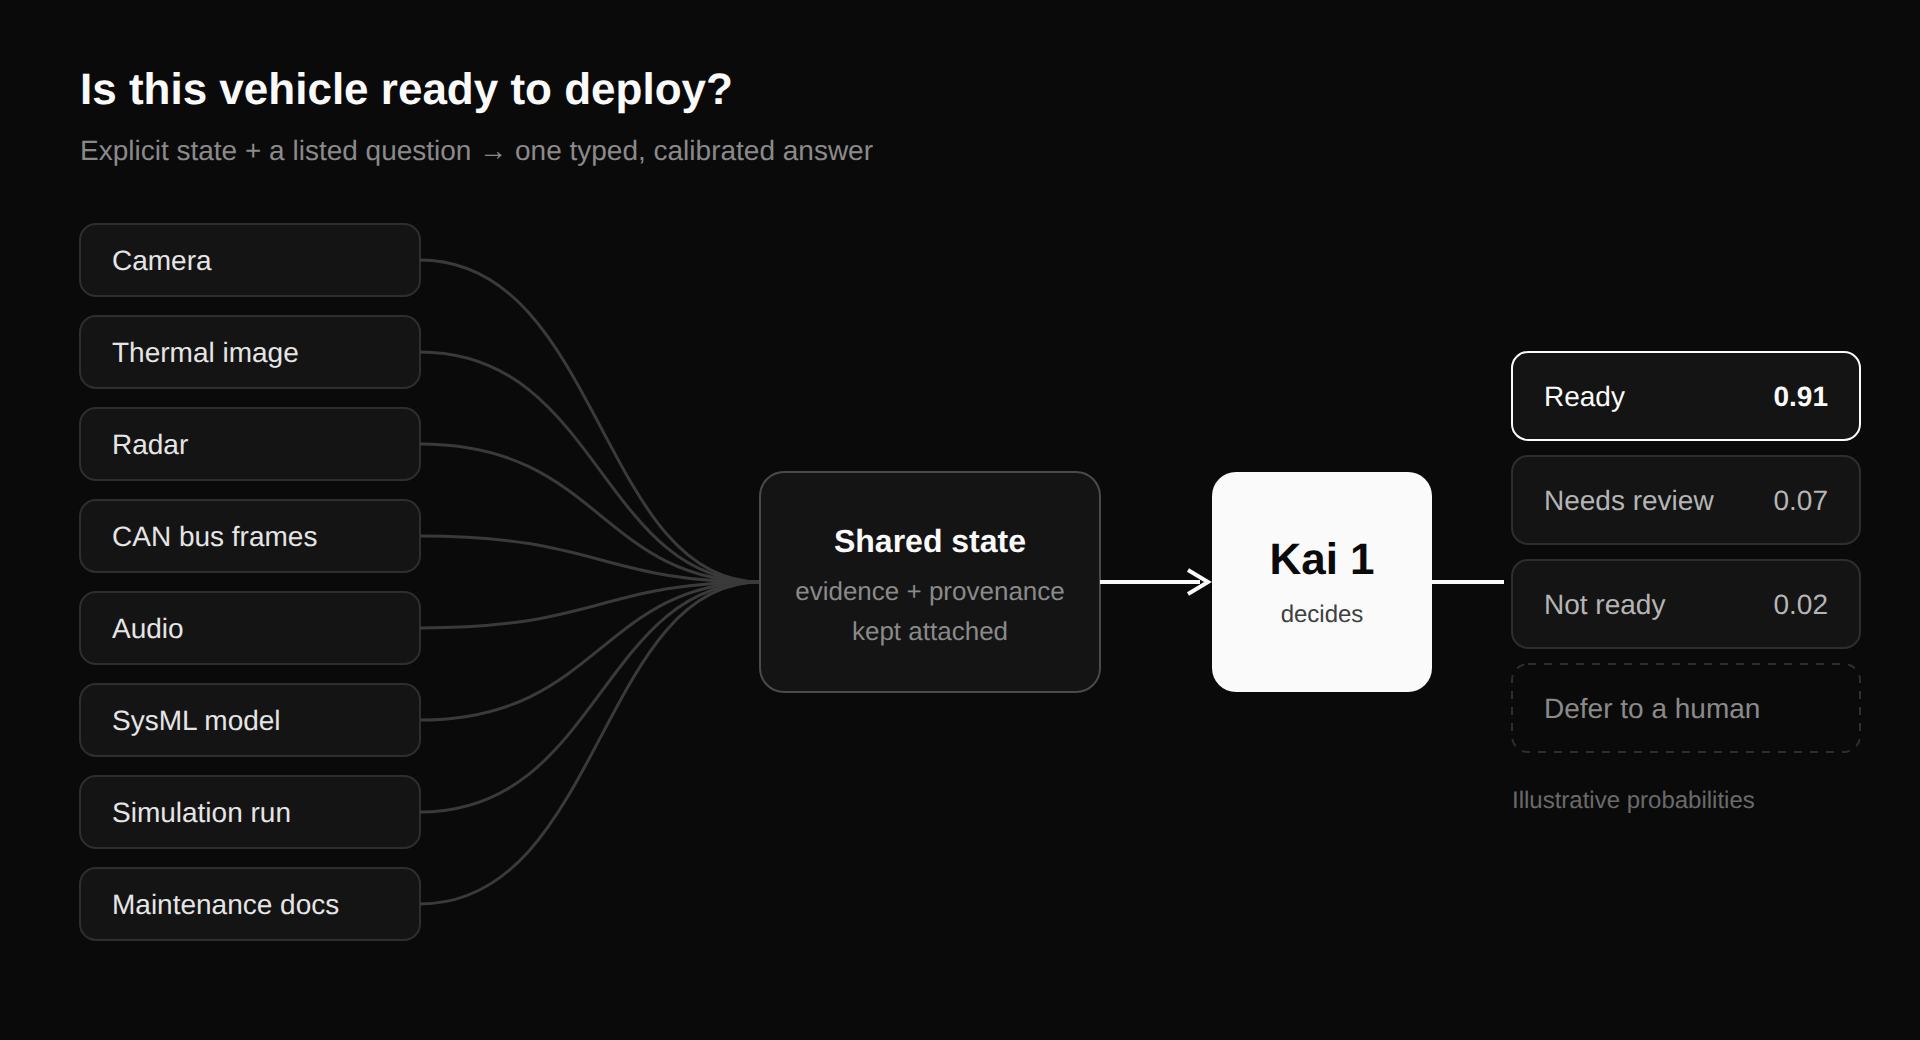
Kai 1: decisiones, no completaciones
Kai es el modelo de decisión de Hanzo y se sirve a través de la Hanzo API. Dadle un estado explícito y una pregunta con opciones listadas, y os devuelve una respuesta tipada y calibrada: una elección, una puntuación, un sí o un no, o un aplazamiento razonado.
El comercio headless cuando quien compra es un LLM
Quien compra empieza a ser un agente. Qué exige que un LLM pueda leer, firmar y pagar sin nadie en medio, y qué ofrece Hanzo hoy para conseguirlo.
Vuestra IA está planeando mataros
Por qué los modelos de frontera fallan cuando hay vidas reales en juego, y cómo Hanzo Kai 1.9 impone una seguridad determinista.