निर्णय मॉडल क्या है?
जनरेटिव मॉडल बिना रोक के अनुच्छेदों में तर्क करते हैं। निर्णय मॉडल टाइप किए गए, अंशांकित अवस्था-संक्रमणों में निर्णय करते हैं। इसीलिए कृत्रिम बुद्धिमत्ता की अगली सीमा जनन नहीं, निर्णय है।
इस पृष्ठ पर
पिछले 3 वर्षों से कृत्रिम बुद्धिमत्ता उद्योग ने हर गणना-समस्या को पाठ जनन की समस्या माना है।
जब किसी स्वायत्त एजेंट को कोई औज़ार चुनना हो, किसी वित्तीय लेनदेन की जाँच करनी हो, किसी सुरक्षा कमजोरी की छँटाई करनी हो, किसी रोबोटिक प्रवर्तक को समायोजित करना हो, या यह तय करना हो कि किसी क्रिया के लिए मानव स्वीकृति चाहिए, तब उद्योग का मानक रहा है कि 70 अरब प्राचल वाले भाषा मॉडल से खुला टोकन-प्रवाह उत्पन्न करवाया जाए। फिर विकासक भंगुर regex प्रतिमान, अटकल वाले JSON विश्लेषक, और पुनःप्रयास के लूप लगाकर उत्तर से एक शब्द या बूलियन झंडा निकालते हैं।
यह तरीका केवल गणना की बरबादी नहीं है। सैकड़ों क्रमिक स्वप्रतिगामी विकोडन चरण खर्च करके ऐसा आउटपुट मिलता है जिसे 2 बिट में दर्शाया जा सकता है। यह वास्तुकला के स्तर पर मौलिक रूप से बेमेल है।
जनरेटिव भाषा मॉडल अगले टोकन की संभावना को अनंत पाठ वितरण पर अधिकतम करने के लिए प्रशिक्षित हुए। वे विवेचनात्मक, संवादात्मक हैं, और अनिश्चितता में संरचनात्मक रूप से भ्रम की ओर झुकते हैं। पर सॉफ़्टवेयर प्रणालियों के नियंत्रण-प्रवाह का 95% किसी निबंध की माँग नहीं करता।
उसे एक निर्णय चाहिए।
भाषा मॉडल तर्क करते हैं। निर्णय मॉडल निर्णय करते हैं।
अंतर समझने के लिए अंतर्निहित उद्देश्य फलन देखिए।
बड़ा भाषा मॉडल (LLM) खुले अनुक्रम पर स्वप्रतिगामी टोकन-संभावना को अनुकूलित करता है:
Loss_LLM = - Σ log P(w_t | w_<t)वह टोकनों का अनुक्रम w_1, w_2, ..., w_n बनाता है, जो 100,000 से अधिक संभावनाओं वाली अबाध शब्दावली से नमूना है। मॉडल यह घोषित नहीं कर सकता कि उत्तर के लिए साक्ष्य कम है, बिना ऐसी प्राकृतिक भाषा रचे जो विनम्रता की नकल करे; वह किसी प्रचालन अवस्था-समष्टि पर मूल प्रायिकता वितरण नहीं दे सकता; और उसके स्वघोषित विश्वास-अंक प्रसिद्ध रूप से अंशांकित नहीं हैं।
निर्णय मॉडल मौलिक रूप से भिन्न उद्देश्य को अनुकूलित करता है। स्पष्ट साक्ष्य-अवस्था E और संरचित निर्णय-समष्टि D दिए होने पर, निर्णय मॉडल परिबद्ध, टाइप किए आउटपुट y तक सीधा प्रतिचित्र निकालता है:
y_hat = argmax_y P(y | E, D)कड़ाई से अंशांकित पश्च वितरण P(y | E) के साथ, और सैद्धांतिक परहेज़ के लिए प्रथम-श्रेणी की प्रचालन आदिम (DEFER) के साथ।
| वास्तुशिल्पीय आयाम | जनरेटिव भाषा मॉडल (LLMs) | निर्णय मॉडल (उदाहरण, Hanzo Kai) |
|---|---|---|
| प्राथमिक उद्देश्य | खुला पाठ-संश्लेषण और जनन | असतत, सत्यापनीय अवस्था-संक्रमण |
| आउटपुट समष्टि | अबाध टोकन अनुक्रम (100k+ शब्दावली) | परिबद्ध, कड़ाई से टाइप किए स्कीमा (Choice, Score, Predicate, Defer) |
| विश्वास और अंशांकन | अनंशांकित; टोकनों पर गढ़ा हुआ सॉफ्टमैक्स | अनुभवजन्य रूप से अंशांकित प्रायिकताएँ (P = 0.90 का अर्थ 90% शुद्धता) |
| अवस्था निरूपण | टोकन स्ट्रिंग की क्षणिक संदर्भ-खिड़की | क्रिप्टोग्राफिक उद्गम के साथ संरचित बहुमोडल साक्ष्य तल |
| निष्पादन संस्थिति | स्वप्रतिगामी क्रमिक विकोडन (O(N) विलंब) | समानांतर ग्राफ समाधान और निर्णय विसरण (O(1) अग्र पास) |
| अनिश्चितता का संचालन | प्रशंसनीय पूर्तियाँ गढ़ता है | सैद्धांतिक परहेज़ (DEFER नीति या मानव समीक्षक को) |
| लेखापरीक्षा योग्यता | अनिर्धारक मौखिक व्याख्याएँ | क्रिप्टोग्राफिक हैश प्रमाणों के साथ अपरिवर्तनीय, पुनःचलायमान निर्णय पैकेज |
जब तर्क को निर्णय से अलग किया जाता है, तब प्रणाली की वास्तुकला परिमाणों के क्रम से सरल, तेज़ और अधिक विश्वसनीय हो जाती है।
निर्णय मॉडल के पाँच वास्तुशिल्पीय स्तंभ
सच्चा निर्णय मॉडल कोई भाषा मॉडल नहीं है जिसे "मान्य JSON में उत्तर दो" कहा गया हो। यह परिबद्ध मूल्यांकन के लिए जड़ से बनी एक समर्पित तंत्रिका वास्तुकला है। Hanzo का मुक्त-भार निर्णय मॉडल, Kai 1, पाँच वास्तुशिल्पीय स्तंभों पर खड़ा है:
1. परिबद्ध, टाइप किए आउटपुट (शून्य स्ट्रिंग विश्लेषण)
उत्पादन सॉफ़्टवेयर में प्रणालियों के बीच हर अंतरापृष्ठ कड़ाई से टाइप किया होना चाहिए। भाषा मॉडल से निर्णय माँगना और आशा करना कि वह regex स्कीमा मानेगा, विनाशकारी पुच्छ-जोखिम लाता है।
निर्णय मॉडल पाठ-विश्लेषण को पूरी तरह हटा देते हैं। हर आउटपुट चार आदिमों में से एक में मूल रूप से टाइप होता है:
Choice<T>: स्पष्ट, परिगणित अभ्यर्थी समुच्चय से एक चयन, सभी विकल्पों पर पूर्ण प्रायिकता वितरण के साथ (p_1, p_2, ..., p_kजहाँΣ p_i = 1.0)।Score[min, max]: स्थिर प्रचालन सीमाओं के भीतर परिबद्ध मात्रात्मक आकलन, विश्वास-अंतरालों सहित।Predicate: शुद्ध बूलियन सत्यापन (trueयाfalse), अंशांकित निश्चितता के साथ।Defer: साक्ष्य अपर्याप्त या परस्पर विरोधी होने पर अनुमान से स्पष्ट इनकार, और निष्पादन को पूर्वनिर्धारित प्रतिसार नीति या लूप में मानव को सौंपना।
क्योंकि आउटपुट परत लॉजिट स्तर पर वैध स्कीमा तक सीमित है, निर्णय मॉडल भौतिक रूप से सीमा-बाह्य परिणाम, अवैध एनम मान, या विकृत पेलोड नहीं बना सकता।
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. एकीकृत बहुमोडल साक्ष्य तल
वास्तविक दुनिया के निर्णय शायद ही केवल पाठ पर टिके हों। संप्रभु वित्त, रोबोटिक हेरफेर, स्वचालित चिकित्सा छँटाई, और औद्योगिक टेलीमेट्री जैसे निर्णायक क्षेत्रों में विषम संकेतों का एक साथ मूल्यांकन चाहिए।
निर्णय मॉडल सारणीबद्ध डेटा, संवेदक फ़ीड और रडार सरणियों को बेढंगे Markdown सारणियों में क्रमबद्ध नहीं करता ताकि कोई भाषा मॉडल उन्हें पढ़े। इसके बजाय Kai विशेष मोडैलिटी कूटलेखक प्रयोग करता है:
- टेलीमेट्री और काल श्रेणी: सदिशीकृत सर्पण खिड़कियाँ और आवृत्ति-क्षेत्र विशेषताएँ।
- दृश्य और तापीय: दृष्टि बैकबोन से सघन दृश्य टोकन।
- संरचित अवस्था: Hanzo Datastore से ग्राफ और संबंधपरक सत्ता प्रक्षेप।
- कोड और विनिर्देश: AST-स्तर के अर्थ एम्बेडिंग और औपचारिक आवश्यकता आव्यूह।
सभी मोडैलिटी एक एकीकृत साक्ष्य तल पर प्रक्षेपित होती हैं। सबसे महत्वपूर्ण, साक्ष्य क्रिप्टोग्राफिक उद्गम रखता है: हर इनपुट टेंसर हैश और अंगुलिचिह्नित होता है। यदि कोई निर्णय 6 महीने बाद जाँचा जाए, तो ठीक वही इनपुट अवस्था बिट-दर-बिट फिर बन सकती है।
3. समानांतर ग्राफ समाधान और निर्णय विसरण
आधुनिक स्वायत्त एजेंटों की सबसे बड़ी अड़चन क्रमिक निष्पादन है। जिस एजेंट लूप को 50 मध्यवर्ती निर्णय चाहिएँ, वह आम तौर पर भाषा मॉडल को क्रम से 50 बार बुलाता है। प्रति पूर्ति 500ms से 2s पर, एजेंट अपने नियंत्रण-प्रवाह को पार करने में ही मिनट लगा देता है।
इसके अलावा, क्रमिक भाषा-मॉडल शृंखलाओं में त्रुटि का प्रसार विनाशकारी है। यदि हर चरण की सफलता दर 95% हो, तो 20 चरणों की शृंखला केवल इतनी सफल होती है:
0.95 ^ 20 ≈ 35.8%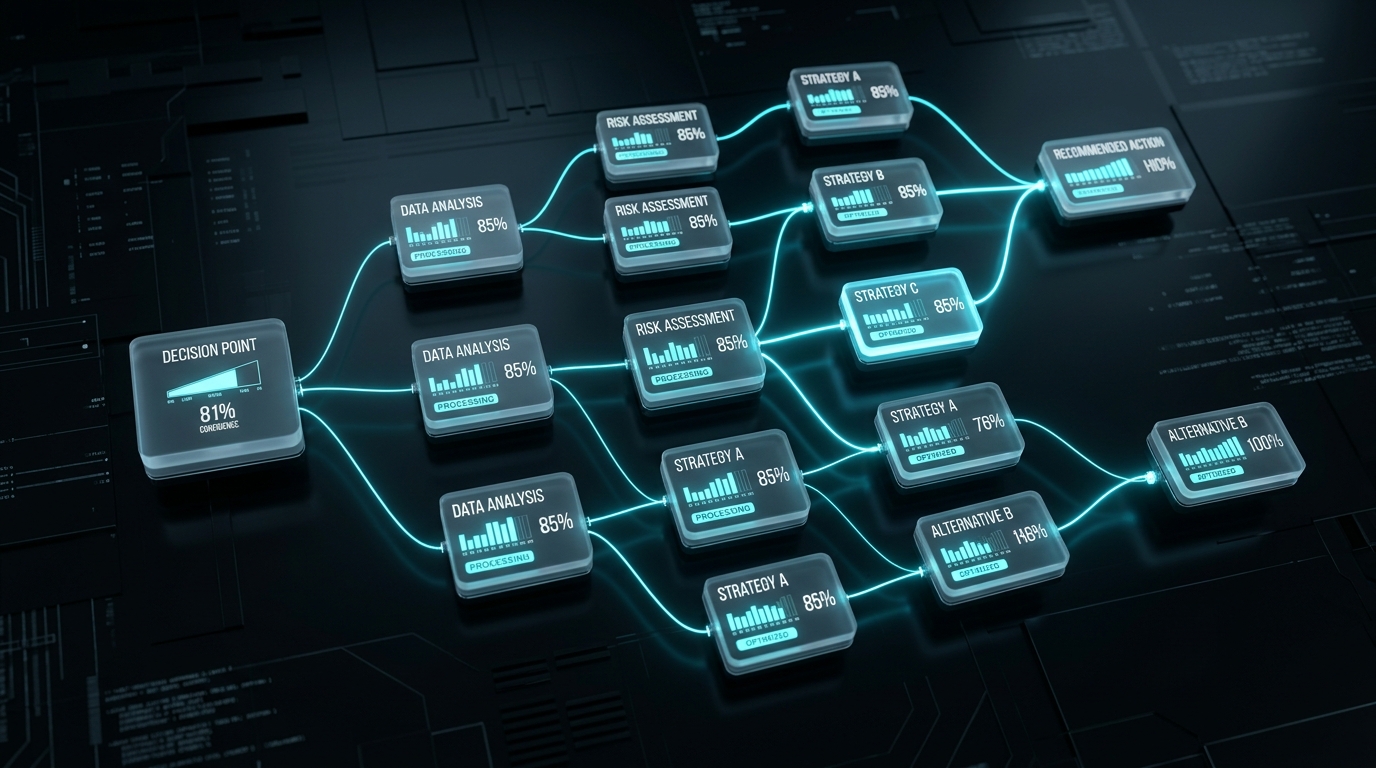
निर्णय मॉडल इसे निर्देशित अचक्रीय ग्राफ (DAGs) पर निर्णय विसरण से हल करते हैं।
निर्णयों का क्रमिक मूल्यांकन करने के बजाय, पूरा निर्णय कार्यक्रम एक साथ जमा होता है। एक ही अग्र पास में:
- पास 1 (तत्काल अभिसरण): असंदिग्ध साक्ष्य वाले 80–90% नोड तुरंत उच्च विश्वास के साथ हल होते हैं (
P > 0.99)। - पास 2 (सशर्त विसरण): आश्रित नोड अपने माता-पिता की लॉक अवस्थाएँ पाकर अपने प्रायिकता वितरण निखारते हैं।
- पास 3 (बाधा संतुष्टि): बचे उच्च-एंट्रॉपी या परस्पर विरोधी नोड औपचारिक सीमा-बाधाओं के विरुद्ध जाँचे जाते हैं।
100 परस्पर आश्रित प्रचालन निर्णयों वाला जटिल कार्यप्रवाह मिनटों में नहीं, मिलीसेकंड में हल होता है।
4. कठोर अंशांकन और सैद्धांतिक परहेज़
यदि कोई मॉडल कहे कि वह 99% आश्वस्त है, तो वह वास्तव में कितनी बार सही होता है?
तैयार जनरेटिव मॉडलों में स्वघोषित विश्वास सत्य से कुख्यात रूप से कमजोर सहसंबद्ध है। मॉडल वितरण-बाह्य इनपुट पर गंभीर अतिविश्वास से ग्रस्त होते हैं, और गलत आउटपुट के लिए विश्वासजनक औचित्य खुशी से गढ़ते हैं।
औद्योगिक, वायुअंतरिक्ष और वित्तीय अनुप्रयोगों में अतिविश्वासी गलत उत्तर घातक है। निर्णय मॉडल अनुभवजन्य रूप से अंशांकित होना चाहिए:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pजब Kai प्रायिकता 0.85 निकालता है, तब वह निर्णय अनुभवजन्य रूप से ठीक 85% बार सही होता है।
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
जब एंट्रॉपी प्राचलित जोखिम-सहन τ से अधिक हो जाए, तब मॉडल अनुमान नहीं लगाता। वह सैद्धांतिक परहेज़ बुलाता है:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERप्रणाली निष्पादन मानव विशेषज्ञों या निर्धारक नियम-पुस्तकों को लौटाती है, और एक स्पष्ट संवेदनशीलता प्रवणता देती है जो बताती है कि कौन-सा अनुपस्थित साक्ष्य एंट्रॉपी सबसे अधिक घटाएगा।
5. पुनःचलायमान निर्णय पैकेज (लेखापरीक्षा पथ)
विनियमित उद्यम परिवेशों में "कृत्रिम बुद्धिमत्ता ने यह पाठ बनाया" न तो वैध कानूनी बचाव है और न अनुपालन की मुद्रा।
Kai द्वारा जाँचा गया हर निर्णय एक अपरिवर्तनीय, क्रिप्टोग्राफिक रूप से मुहरबंद निर्णय पैकेज बनाता है:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
यदि कोई लेखापरीक्षक या घटना-प्रतिक्रिया अभियंता वर्षों बाद किसी लेनदेन की पूछताछ करे, तो वह निर्णय पैकेज को ठीक उसी मॉडल संशोधन पर फिर चला सकता है, और सत्यापित कर सकता है कि आउटपुट गणितीय रूप से निर्धारक, छेड़छाड़-रोधी और नीति के अनुरूप था।
आपके स्टैक में निर्णय मॉडल कहाँ बैठते हैं
निर्णय मॉडल जनरेटिव मॉडल की जगह नहीं लेते। वे जनरेटिव मॉडल को उन कामों से मुक्त करते हैं जिनके लिए वे कभी बने ही नहीं थे।
आधुनिक उद्यम वास्तुकला में प्रणालियाँ तब फलती हैं जब कार्य जनन और नियंत्रण के बीच साफ-साफ बँटे हों:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo के अग्रणी जनरेटिव तर्क मॉडल। Zen तब प्रयोग कीजिए जब गहरा पाठ अनुसंधान, बहु-चरण विचार-शृंखला प्रमाण, रचनात्मक संश्लेषण और दस्तावेज़ प्रारूपण चाहिए।
- Kai: Hanzo का मुक्त-भार निर्णय मॉडल परिवार। Kai तब प्रयोग कीजिए जब निर्धारक मार्ग, औज़ार चयन, सुरक्षा देहली, व्यापार निष्पादन, छँटाई और एजेंट-लूप नियंत्रण चाहिए।
- Enso: उच्च-थ्रूपुट मेटा-राउटर, जो माइक्रोसेकंड परत पर आने वाले कार्य देखता है, जनन कार्य Zen को और निर्णय कार्य Kai को भेजता है।
मुक्त भार। संप्रभु अवसंरचना।
विश्वसनीय निर्णय अवसंरचना को किसी बंद तृतीय-पक्ष API में बंद नहीं किया जा सकता जो बिना सूचना व्यवहार बदल दे। जब कोई मॉडल उत्पादन परिनियोजन, भौतिक प्रणालियों या वित्तीय जोखिम को नियंत्रित करे, तब उसके भार, रनटाइम और डेटा गोपनीयता पर पूरी संप्रभुता होनी चाहिए।
Kai 1 मुक्त भार है। आप इसे चला सकते हैं:
- Hanzo Sovereign Cloud पर: वैश्विक पैमाने पर, शून्य-निर्गम गारंटी और उप-मिलीसेकंड विलंब के साथ।
- अपने VPC या परिसर में: Docker या Kubernetes से NVIDIA GPU, AMD ROCm, या उच्च-घनत्व CPU नोड पर परिनियोजन योग्य।
- किनारे पर: रोबोटिक्स, वायुअंतरिक्ष और संप्रभु रक्षा परिवेशों के लिए पूरी तरह असंबद्ध।
जब आपके सॉफ़्टवेयर को केवल एक निर्णय चाहिए, तब भाषा मॉडल से निबंध न लिखवाइए।
निर्णय बुद्धिमत्ता के युग में स्वागत है।
संपूर्ति नहीं, निर्णय
आज Kai को Hanzo Cloud API से चलाइए, या मुक्त भार डाउनलोड कीजिए ताकि अंशांकित निर्णय मॉडल अपनी संप्रभु अवसंरचना में परिनियोजित हों।
और पढ़ें
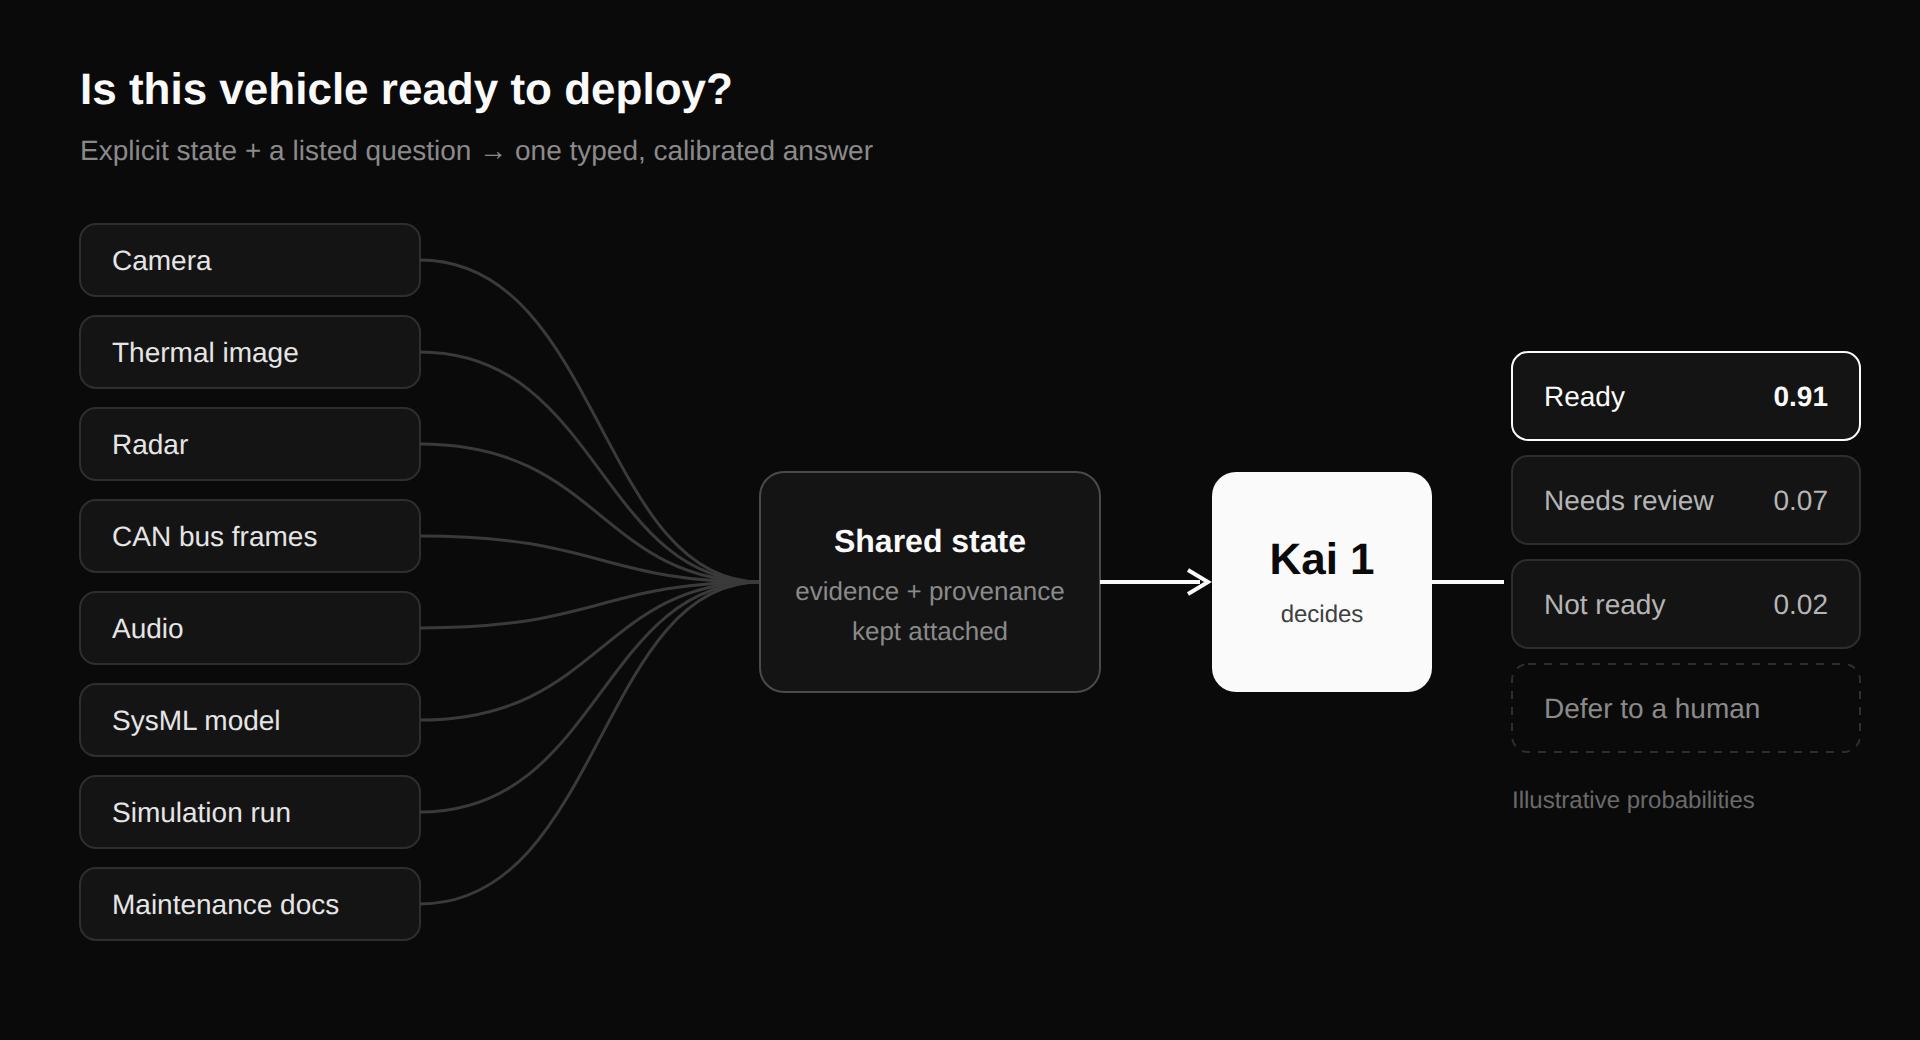
Kai 1: संपूर्ति नहीं, निर्णय
Kai, Hanzo का निर्णय मॉडल है, और Hanzo API पर मिलता है। इसे स्पष्ट अवस्था और विकल्पों वाला प्रश्न दीजिए; यह एक टाइप किया, अंशांकित उत्तर लौटाता है — चुनाव, अंक, हाँ/नहीं, या तर्क सहित टालना।
एजेंटिक एलएलएम के युग में हेडलेस कॉमर्स की तैयारी
खरीदार एजेंट बन रहे हैं। बिना मनुष्य के किसी एलएलएम के लिए पठनीय, हस्ताक्षर-योग्य और भुगतान-योग्य होने में क्या लगता है, और Hanzo आज उसके लिए क्या देता है।
आपकी एआई आपको मारने की योजना बना रही है
जब असली ज़िंदगियाँ दाँव पर हों तो सीमांत मॉडल क्यों विफल होते हैं, और Hanzo Kai 1.9 नियतात्मक सुरक्षा कैसे लागू करता है।