의사결정 모델이란 무엇인가?
생성 모델은 제약 없는 문단으로 추론한다. 의사결정 모델은 타입이 지정되고 보정된 상태 전이로 결정한다. 인공지능의 다음 프런티어가 생성이 아니라 결정인 이유를 밝힌다.
이 페이지에서
지난 3년 동안 인공지능 산업은 모든 계산 문제를 텍스트 생성 문제로 다뤄 왔다.
자율 에이전트가 도구를 고르고, 금융 거래를 검증하고, 보안 취약점을 분류하고, 로봇 액추에이터를 조정하고, 어떤 행동에 사람의 승인이 필요한지 정해야 할 때, 업계 표준은 700억 개 매개변수의 언어 모델에게 열린 토큰 흐름을 생성하게 하는 것이었다. 개발자는 이어서 취약한 정규식, 추측에 의존하는 JSON 파서, 재시도 루프를 두어 응답에서 한 단어나 불리언 플래그를 뽑아 낸다.
그 방식은 계산 낭비에 그치지 않는다. 직렬 자기회귀 복호를 수백 단계 써서, 2비트로 나타낼 수 있는 출력을 얻는다. 아키텍처로서 근본적으로 맞지 않는다.
생성 언어 모델은 무한한 텍스트 분포 위에서 다음 토큰의 우도를 최대화하도록 훈련되었다. 그것들은 논술적이고 대화적이며, 불확실성 아래에서는 구조적으로 환각에 기울어진다. 그러나 소프트웨어 시스템 제어 흐름의 95%는 에세이를 필요로 하지 않는다.
필요한 것은 결정이다.
언어 모델은 추론한다. 의사결정 모델은 결정한다.
차이를 이해하려면 그 아래의 목적 함수를 보면 된다.
대규모 언어 모델(LLM)은 열린 수열 위에서 자기회귀 토큰 우도를 최적화한다:
Loss_LLM = - Σ log P(w_t | w_<t)그것은 100,000가지가 넘는 가능성을 가진 제약 없는 어휘에서 표본된 토큰 열 w_1, w_2, ..., w_n을 생성한다. 모델은 겸손을 흉내 내는 자연어를 만들지 않고는 답할 증거가 부족하다고 선언할 수 없다. 운용 상태 공간 위의 고유한 확률 분포를 낼 수 없고, 스스로 보고하는 확신 수치는 보정되지 않기로 유명하다.
의사결정 모델은 근본적으로 다른 목적을 최적화한다. 명시적인 증거 상태 E과 구조화된 결정 공간 D이 주어지면, 유계이고 타입이 있는 출력 y로의 직접 사상을 계산한다:
y_hat = argmax_y P(y | E, D)엄격히 보정된 사후 분포 P(y | E)과, 원칙적 기권을 위한 일급 운용 프리미티브(DEFER)를 갖춘다.
| 아키텍처 차원 | 생성 언어 모델(LLMs) | 의사결정 모델(예: Hanzo Kai) |
|---|---|---|
| 주된 목적 | 열린 텍스트 합성과 생성 | 이산적이고 검증 가능한 상태 전이 |
| 출력 공간 | 제약 없는 토큰 열(어휘 100k+) | 유계이고 엄격히 타입이 지정된 스키마(Choice, Score, Predicate, Defer) |
| 확신과 보정 | 미보정. 토큰 위의 날조된 소프트맥스 | 경험적으로 보정된 확률(P = 0.90은 정확도 90%를 뜻한다) |
| 상태 표현 | 토큰 문자열의 일시적인 문맥 창 | 암호학적 출처를 가진 구조화된 다중모달 증거 평면 |
| 실행 위상 | 자기회귀 직렬 복호(지연 O(N)) | 병렬 그래프 해결과 결정 확산(순방향 패스 O(1)) |
| 불확실성 처리 | 그럴듯한 완성을 환각한다 | 원칙적 기권(DEFER을 정책 또는 사람 검토자에게) |
| 감사 가능성 | 비결정적인 말의 설명 | 암호 해시 증명을 갖춘, 불변이고 재생 가능한 결정 패키지 |
추론과 결정을 나누면 시스템 아키텍처는 자릿수가 다르게 단순하고, 빠르고, 신뢰할 수 있게 된다.
의사결정 모델의 다섯 아키텍처 기둥
진정한 의사결정 모델은 *"유효한 JSON으로 응답하라"*고 프롬프트된 언어 모델이 아니다. 유계 평가를 위해 바닥부터 설계된 전용 신경 아키텍처이다. Hanzo의 오픈 웨이트 의사결정 모델 Kai 1은 다섯 아키텍처 기둥 위에 서 있다:
1. 유계이고 타입이 있는 출력(문자열 파싱 없음)
프로덕션 소프트웨어에서 시스템 사이의 모든 인터페이스는 엄격히 타입이 지정되어야 한다. 언어 모델에게 결정을 내고 정규식 스키마를 지키리라 바라는 것은 파국적인 꼬리 위험을 들인다.
의사결정 모델은 텍스트 파싱을 완전히 없앤다. 모든 출력은 네 가지 프리미티브 중 하나로 고유하게 타입이 지정된다:
Choice<T>: 명시적으로 열거된 후보 집합에서 하나 선택. 모든 대안에 대한 완전한 확률 분포를 동반한다(p_1, p_2, ..., p_k, 여기서Σ p_i = 1.0).Score[min, max]: 고정된 운용 경계 안에 갇힌 정량 평가. 신뢰 구간을 포함한다.Predicate: 보정된 확실성을 가진 순수한 불리언 검증(true또는false).Defer: 증거가 부족하거나 충돌할 때 추측을 명시적으로 거부하고, 실행을 미리 정한 폴백 정책이나 루프 안의 사람에게 넘긴다.
출력 층이 로짓 단계에서 유효한 스키마로 제한되므로, 의사결정 모델은 범위 밖 결과, 불법 열거 값, 깨진 페이로드를 물리적으로 만들 수 없다.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. 통합 다중모달 증거 평면
현실의 결정은 텍스트에만 의존하는 경우가 드물다. 주권 금융, 로봇 조작, 자동 의료 분류, 산업 원격 측정 같은 핵심 영역에서는 이질적 신호를 동시에 평가해야 한다.
의사결정 모델은 표 데이터, 센서 피드, 레이더 배열을 언어 모델이 읽도록 서툰 Markdown 표로 직렬화하지 않는다. 대신 Kai는 전용 모달리티 부호화기를 쓴다:
- 원격 측정과 시계열: 벡터화된 이동 창과 주파수 영역 특징.
- 시각과 열: 시각 백본에서 온 조밀한 시각 토큰.
- 구조화 상태: Hanzo Datastore의 그래프 및 관계 엔티티 사영.
- 코드와 명세: AST 수준의 의미 임베딩과 형식 요구 행렬.
모든 모달리티는 통합 증거 평면으로 사영된다. 가장 중요한 것은 증거가 암호학적 출처를 유지한다는 점이다. 각 입력 텐서는 해시되고 지문이 찍힌다. 결정이 6개월 뒤에 감사되어도 입력 상태를 비트 단위로 재구성할 수 있다.
3. 병렬 그래프 해결과 결정 확산
현대 자율 에이전트의 가장 큰 병목은 직렬 실행이다. 중간 결정이 50번 필요한 에이전트 루프는 보통 언어 모델을 순서대로 50번 호출한다. 완성 한 번에 500ms에서 2s이면, 에이전트는 자기 제어 흐름을 훑는 데만 몇 분을 쓴다.
게다가 직렬 언어 모델 연쇄의 오류 전파는 파국적이다. 각 단계의 성공률이 95%이면, 20단계 연쇄가 성공하는 정도는 다음뿐이다:
0.95 ^ 20 ≈ 35.8%
의사결정 모델은 방향 비순환 그래프(DAGs) 위의 결정 확산으로 이것을 푼다.
결정을 직렬로 평가하는 대신, 결정 프로그램 전체를 한 번에 제출한다. 한 번의 순방향 패스에서:
- 패스 1(즉시 수렴): 증거가 모호하지 않은 노드의 80–90%가 높은 신뢰로 즉시 풀린다(
P > 0.99). - 패스 2(조건부 확산): 의존 노드는 부모의 잠긴 상태를 받아 확률 분포를 다듬는다.
- 패스 3(제약 만족): 남은 고엔트로피 또는 충돌 노드는 형식적 경계 제약에 비추어 평가된다.
서로 의존하는 운용 결정 100개를 담은 복잡한 워크플로는 분이 아니라 밀리초 안에 풀린다.
4. 엄밀한 보정과 원칙적 기권
인공지능 모델이 99% 확신한다고 말할 때, 실제로 옳은 경우는 얼마나 잦은가?
기성 생성 모델에서 스스로 보고한 확신은 진실과의 상관이 악명 높게 약하다. 모델은 분포 밖 입력에서 심한 과신에 시달리고, 틀린 출력에 그럴듯한 정당화를 기꺼이 환각한다.
산업, 항공우주, 금융 응용에서 과신한 오답은 치명적이다. 의사결정 모델은 경험적으로 보정되어야 한다:
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pKai가 확률 0.85을 내면, 그 결정은 경험적으로 정확히 85%의 경우에 옳다.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
엔트로피가 매개변수화된 위험 허용 τ을 넘으면 모델은 추측하지 않는다. 원칙적 기권을 호출한다:
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFER시스템은 실행을 사람 전문가나 결정적 규칙집으로 되돌리고, 어떤 빠진 증거가 엔트로피를 가장 많이 낮출지 가리키는 명시적 민감도 기울기를 제공한다.
5. 재생 가능한 결정 패키지(감사 추적)
규제된 기업 환경에서 *"인공지능이 이 텍스트를 생성했다"*는 유효한 법적 항변도, 준법 자세도 아니다.
Kai가 평가하는 모든 결정은 불변이고 암호학적으로 봉인된 결정 패키지를 만든다:
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
감사인이나 사고 대응 엔지니어가 여러 해 뒤에 거래를 조회하면, 같은 모델 개정에 대해 결정 패키지를 재생하고, 출력이 수학적으로 결정적이며 변조에 견디고 정책을 지켰는지 검증할 수 있다.
의사결정 모델은 스택의 어디에 두는가
의사결정 모델은 생성 모델을 대체하지 않는다. 생성 모델이 하도록 설계된 적 없는 일에서 생성 모델을 덜어 준다.
현대 기업 아키텍처에서 시스템은 생성과 제어 사이에서 작업을 깨끗이 나눌 때 잘 자란다:
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen: Hanzo의 프런티어 생성 추론 모델. 깊은 텍스트 조사, 다단계 사고 사슬 증명, 창의적 합성, 문서 초안이 필요할 때 Zen을 쓴다.
- Kai: Hanzo의 오픈 웨이트 의사결정 모델 가족. 결정적 라우팅, 도구 선택, 안전 임계, 거래 집행, 분류, 에이전트 루프 제어가 필요할 때 Kai를 쓴다.
- Enso: 마이크로초 층에서 들어오는 작업을 살펴, 생성 작업은 Zen으로, 결정 작업은 Kai로 보내는 고처리량 메타 라우터.
오픈 웨이트. 주권 인프라.
신뢰할 수 있는 결정 인프라를, 예고 없이 행동을 바꾸는 닫힌 제삼자 API 안에 가두어 둘 수 없다. 모델이 프로덕션 배포, 물리 시스템, 또는 금융 위험을 다룰 때, 그 가중치와 런타임과 데이터 프라이버시에 대한 완전한 주권이 있어야 한다.
Kai 1은 오픈 웨이트이다. 다음에서 실행할 수 있다:
- Hanzo Sovereign Cloud에서: 무유출 보장과 밀리초 미만 지연으로 전역에 확장된다.
- 자체 VPC 또는 온프레미스: Docker 또는 Kubernetes로 NVIDIA GPU, AMD ROCm, 또는 고밀도 CPU 노드에 배포할 수 있다.
- 에지에서: 로봇, 항공우주, 주권 방어 환경을 위해 완전히 끊고 둔다.
소프트웨어에 필요한 것이 결정뿐이라면, 언어 모델에게 에세이를 쓰라고 하지 말라.
의사결정 지능의 시대에 오신 것을 환영한다.
텍스트 완성이 아니라 결정
오늘 Kai를 Hanzo Cloud API로 실행하거나, 오픈 웨이트를 받아 보정된 의사결정 모델을 주권 인프라 안에 배포하라.
더 읽기
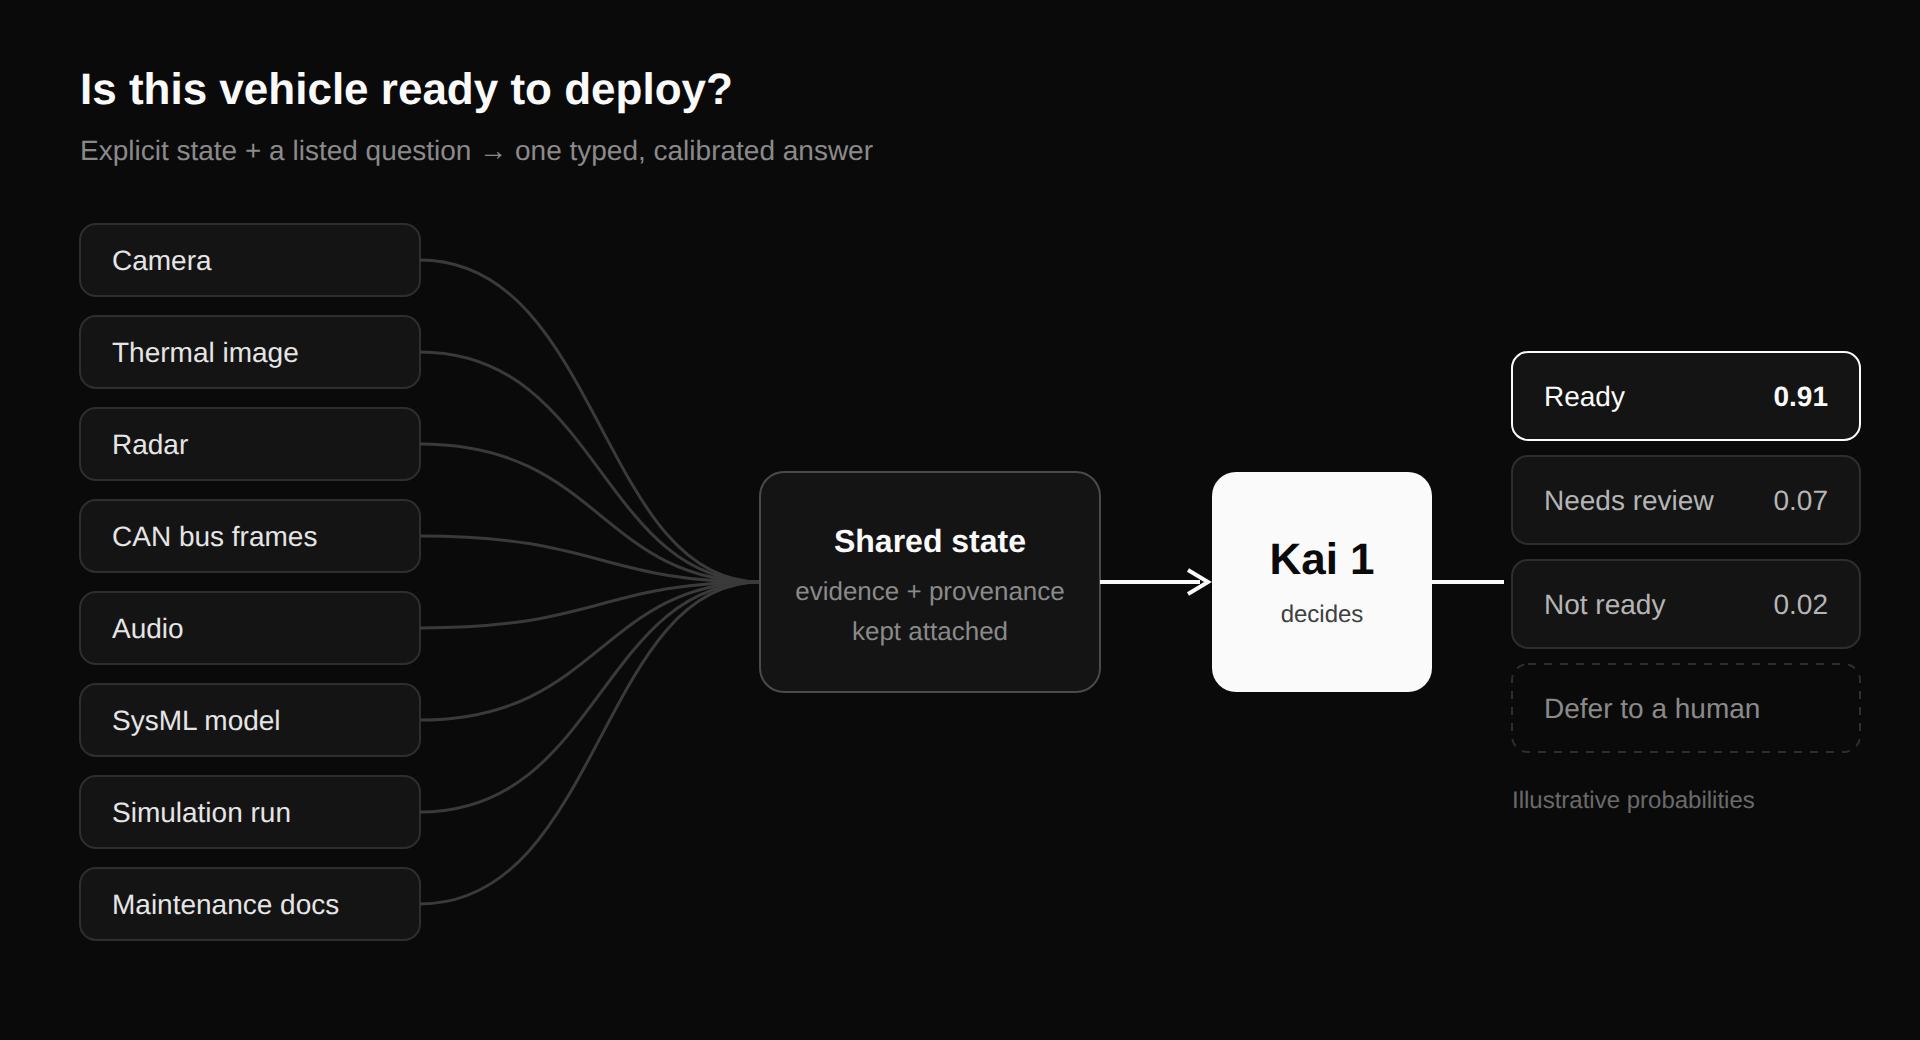
Kai 1: 텍스트 완성이 아니라 결정
Kai는 Hanzo의 의사결정 모델이며, Hanzo API로 제공됩니다. 명시적인 상태와 선택지가 나열된 질문을 주면, 타입이 지정되고 보정된 답을 돌려줍니다 — 선택, 점수, 예/아니오, 또는 근거를 갖춘 보류입니다.
에이전트형 언어 모델 시대에 헤드리스 커머스를 맞추다
구매자는 에이전트가 되고 있다. 사람이 끼지 않아도 거대언어모델이 읽고, 서명하고, 결제할 수 있게 하려면 무엇이 필요한지, 그리고 Hanzo가 오늘 그것을 위해 내놓는 것.
당신의 AI는 당신을 죽일 계획을 세우고 있다
실제 목숨이 걸린 자리에서 프런티어 모델이 왜 실패하는지, 그리고 Hanzo Kai 1.9가 결정론적 안전을 어떻게 강제하는지.