Qu'est-ce qu'un modèle de décision ?
Les modèles génératifs raisonnent en paragraphes sans contrainte. Les modèles de décision tranchent par des transitions d'état typées et calibrées. Voici pourquoi la prochaine frontière de l'IA n'est pas la génération, mais la décision.
Sur cette page
Pendant trois ans, l'industrie de l'IA a traité chaque problème de calcul comme un problème de génération de texte.
Quand un agent autonome doit choisir un outil, vérifier une transaction financière, trier une vulnérabilité de sécurité, régler un actionneur robotique ou déterminer si une action exige une approbation humaine, la norme du secteur a été d'interroger un modèle de langage de 70 milliards de paramètres et d'attendre qu'il produise un flux ouvert de jetons. Les développeurs déploient ensuite des motifs regex fragiles, des analyseurs JSON spéculatifs et des boucles de nouvel essai pour extraire de la réponse un seul mot ou un booléen.
Cette approche ne gaspille pas seulement du calcul : elle dépense des centaines d'étapes de décodage autorégressif en série pour une sortie qui tiendrait dans deux bits. Elle est, au fond, inadaptée à l'architecture.
Les modèles de langage génératifs ont été entraînés pour maximiser la vraisemblance du jeton suivant sur une distribution textuelle infinie. Ils sont discursifs, conversationnels et, par leur structure, enclins à halluciner dès qu'il y a de l'incertitude. Or 95% du flux de contrôle dans les systèmes logiciels n'a pas besoin d'une dissertation.
Il a besoin d'une décision.
Les modèles de langage raisonnent. Les modèles de décision décident.
Pour saisir la différence, regardez les fonctions objectif sous-jacentes.
Un grand modèle de langage (LLM) optimise la vraisemblance autorégressive des jetons sur une séquence ouverte :
Loss_LLM = - Σ log P(w_t | w_<t)Il génère une séquence de jetons w_1, w_2, ..., w_n, tirée d'un vocabulaire sans borne de plus de 100,000 possibilités. Le modèle ne peut pas déclarer qu'il lui manque la preuve pour répondre sans produire des phrases de langage naturel qui imitent la modestie ; il ne peut pas émettre une distribution de probabilité native sur un espace d'états opérationnel ; et les chiffres de confiance qu'il annonce lui-même sont notoirement mal calibrés.
Un modèle de décision optimise un objectif tout autre. À partir d'un état de preuve explicite E et d'un espace de décision structuré D, un modèle de décision calcule une projection directe vers une sortie bornée et typée y :
y_hat = argmax_y P(y | E, D)Il est muni d'une distribution a posteriori strictement calibrée P(y | E) et d'une primitive opérationnelle de premier rang pour l'abstention raisonnée (DEFER).
| Dimension d'architecture | Modèles de langage génératifs (LLM) | Modèles de décision (p. ex. Hanzo Kai) |
|---|---|---|
| Objectif principal | Synthèse et génération de texte ouvert | Transitions d'état discrètes et vérifiables |
| Espace de sortie | Séquences de jetons sans borne (vocabulaire de 100k+) | Schémas bornés et strictement typés (Choice, Score, Predicate, Defer) |
| Confiance et calibration | Non calibrée ; softmax affabulée sur les jetons | Probabilités calibrées empiriquement (P = 0.90 implique 90% d'exactitude) |
| Représentation de l'état | Fenêtre de contexte éphémère, faite de chaînes de jetons | Plan de preuve multimodal structuré, avec provenance cryptographique |
| Topologie d'exécution | Décodage autorégressif en série (latence O(N)) | Résolution de graphes en parallèle et diffusion de décision (passe avant O(1)) |
| Traitement de l'incertitude | Hallucine des complétions plausibles | Abstention raisonnée (DEFER vers une politique ou un relecteur humain) |
| Auditabilité | Explications verbales non déterministes | Paquets de décision immuables et rejouables, avec preuves de hachage cryptographique |
Quand vous séparez le raisonnement de la décision, l'architecture du système devient plus simple, plus rapide et plus fiable, de plusieurs ordres de grandeur.
Les cinq piliers d'architecture d'un modèle de décision
Un vrai modèle de décision n'est pas un LLM auquel on demande « Répondez avec du JSON valide ». C'est une architecture neuronale dédiée, conçue depuis la base pour une évaluation bornée. Le modèle de décision à poids ouverts de Hanzo, Kai 1, repose sur cinq piliers d'architecture :
1. Sorties bornées et typées (zéro analyse de chaînes)
Dans un logiciel en production, chaque interface entre systèmes doit être strictement typée. Demander à un modèle de langage de produire une décision et espérer qu'il respecte un schéma regex introduit un risque de queue catastrophique.
Les modèles de décision suppriment entièrement l'analyse du texte. Chaque sortie est typée nativement dans l'une de quatre primitives :
Choice<T>: une sélection dans un ensemble explicite et énuméré de candidats, accompagnée de la distribution de probabilité complète sur toutes les alternatives (p_1, p_2, ..., p_k, oùΣ p_i = 1.0).Score[min, max]: une note quantitative bornée dans des limites opérationnelles fixes, avec ses intervalles de confiance.Predicate: une vérification booléenne pure (trueoufalse) avec une certitude calibrée.Defer: un refus explicite de deviner quand la preuve est insuffisante ou contradictoire, l'exécution étant remise à une politique de repli définie à l'avance ou à un humain dans la boucle.
Comme la couche de sortie est contrainte au schéma valide au niveau des logits, un modèle de décision ne peut physiquement pas produire un résultat hors limites, une valeur d'énumération illégale ou une charge mal formée.
// Calling Hanzo Kai 1 via the unified SDK:
const decision = await kai.decide({
  question: "deploy_canary_to_production",
  schema: {
    type: "choice",
    options: ["promote", "rollback", "quarantine", "defer_to_sre"],
  },
  evidence: [
    { type: "p99_latency_ms", value: 142, threshold: 150 },
    { type: "error_rate_delta", value: "+0.002%", threshold: "+0.01%" },
    { type: "canary_health_score", value: 0.98 },
  ],
});

// The result is directly typed, validated, and calibrated:
console.log(decision.result);      // "promote"
console.log(decision.probability); // 0.964
console.log(decision.entropy);     // 0.12 (low uncertainty)
2. Le plan de preuve multimodal unifié
Dans le monde réel, les décisions dépendent rarement du seul texte. Dans les domaines critiques — finance souveraine, manipulation robotique, triage médical automatisé et télémétrie industrielle — il faut évaluer des signaux hétérogènes en même temps.
Un modèle de décision ne sérialise pas des données tabulaires, des flux de capteurs et des réseaux radar en tableaux Markdown maladroits pour qu'un LLM les lise. Kai utilise à la place des encodeurs de modalité spécialisés :
- Télémétrie et séries temporelles : fenêtres glissantes vectorisées et traits du domaine fréquentiel.
- Visuel et thermique : jetons visuels denses issus de backbones de vision.
- État structuré : projections d'entités en graphe et relationnelles, tirées du Hanzo Datastore.
- Code et spécifications : plongements sémantiques au niveau de l'AST et matrices d'exigences formelles.
Toutes les modalités se projettent dans un plan de preuve unifié. Surtout, la preuve conserve une provenance cryptographique : chaque tenseur d'entrée est haché et empreinté. Si une décision est auditée six mois plus tard, l'état exact de l'entrée peut être reconstruit bit à bit.
3. Résolution de graphes en parallèle et diffusion de décision
Le plus grand goulet des agents autonomes modernes est l'exécution en série. Une boucle d'agent qui exige 50 décisions intermédiaires appelle en général un LLM 50 fois de suite. À 500ms jusqu'à 2s par complétion, l'agent passe des minutes à seulement parcourir son propre flux de contrôle.
De plus, la propagation des erreurs dans les chaînes sérielles de LLM est catastrophique. Si chaque étape a un taux de succès de 95%, une chaîne de 20 étapes ne réussit que dans :
0.95 ^ 20 ≈ 35.8%
Les modèles de décision règlent cela par la diffusion de décision sur des graphes orientés acycliques (DAG).
Au lieu d'évaluer les décisions en série, le programme de décision entier est soumis d'un coup. En une seule passe avant :
- Passe 1 (convergence immédiate) : 80–90% des nœuds dont la preuve est sans ambiguïté se résolvent aussitôt, avec une confiance élevée (
P > 0.99). - Passe 2 (diffusion conditionnelle) : les nœuds dépendants reçoivent les états verrouillés de leurs parents et affinent leurs distributions de probabilité.
- Passe 3 (satisfaction de contraintes) : les nœuds qui restent à haute entropie, ou en conflit, sont évalués contre des contraintes de frontière formelles.
Un flux complexe de 100 décisions opérationnelles interdépendantes se résout en millisecondes, pas en minutes.
4. Calibration rigoureuse et abstention raisonnée
Si un modèle d'IA vous dit qu'il est confiant à 99%, à quelle fréquence a-t-il vraiment raison ?
Pour les modèles génératifs sur étagère, la confiance qu'ils annoncent eux-mêmes est notoirement mal corrélée à la vérité. Ils souffrent d'un excès de confiance sévère sur les entrées hors distribution et hallucinent volontiers des justifications convaincantes de sorties erronées.
Dans les applications industrielles, aérospatiales et financières, une mauvaise réponse trop sûre est fatale. Un modèle de décision doit être calibré empiriquement :
E[ Indicator(y_pred == y_true) | P(y_pred) = p ] = pQuand Kai produit une probabilité de 0.85, cette décision est empiriquement correcte exactement 85% du temps.
       Uncalibrated LLM (Overconfident)            Calibrated Decision Model (Kai)
  1.0 |                    /                 1.0 |                     /
      |                   /                      |                   /
A 0.8 |             _____/                 A 0.8 |                 /
C     |            /                       C     |               /
C 0.6 |           /                        C 0.6 |             /
      |          /                         |          /
  0.4 |    _____/                          0.4 |        /
      |   /                                      |      /
  0.2 |  /                                   0.2 |    /
      | /                                        |  /
  0.0 +----------------------                0.0 +----------------------
      0.0  0.2  0.4  0.6  0.8  1.0               0.0  0.2  0.4  0.6  0.8  1.0
             CONFIDENCE                                 CONFIDENCE
Quand l'entropie dépasse une tolérance au risque paramétrée τ, le modèle ne devine pas. Il invoque l'abstention raisonnée :
Entropy(P(y | E)) = - Σ p_i * log(p_i) > τ ==> DEFERLe système rend l'exécution à des spécialistes humains ou à des règlements déterministes, et fournit un gradient de sensibilité explicite qui indique quel élément de preuve manquant réduirait le plus l'entropie.
5. Paquets de décision rejouables (la piste d'audit)
Dans les environnements d'entreprise régulés, « l'IA a généré ce texte » n'est ni une défense juridique valable ni une posture de conformité.
Chaque décision évaluée par Kai produit un paquet de décision immuable et scellé cryptographiquement :
{
  "decision_id": "dec_8f0a2c91b4",
  "program_version": "fraud_triage_v2.4",
  "timestamp": "2026-09-30T19:00:00Z",
  "model": {
    "name": "kai-1-core",
    "weights_sha256": "e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855"
  },
  "evidence_fingerprints": {
    "transaction_context": "sha256:7c9e...",
    "biometric_telemetry": "sha256:4a1d...",
    "historical_risk_profile": "sha256:9f8b..."
  },
  "posterior_distribution": {
    "approve": 0.012,
    "step_up_mfa": 0.976,
    "terminate_session": 0.009,
    "defer_to_fraud_desk": 0.003
  },
  "selected_action": "step_up_mfa",
  "entropy": 0.098,
  "signature": "ed25519:3b7a8f..."
}
Si un auditeur ou un ingénieur de réponse à incident interroge une transaction des années plus tard, il peut rejouer le paquet de décision contre la révision exacte du modèle et vérifier que la sortie était mathématiquement déterministe, à l'épreuve de la falsification et conforme à la politique.
Où les modèles de décision prennent place dans votre pile
Les modèles de décision ne remplacent pas les modèles génératifs. Ils déchargent les modèles génératifs des tâches pour lesquelles ils n'ont jamais été conçus.
Dans les architectures d'entreprise modernes, les systèmes tiennent quand les tâches sont séparées nettement entre génération et contrôle :
                          ┌──────────────────────────┐
                          │   Incoming Workload      │
                          └─────────────┬────────────┘
                                        │
                                        ▼
                          ┌──────────────────────────┐
                          │       Enso Router        │
                          │  (Task Intent & Triage)  │
                          └──────┬────────────┬──────┘
                                 │            │
             Generative Tasks    │            │   Control & Decision Tasks
       (Code, Research, Content) │            │   (Routing, Approvals, Safety)
                                 ▼            ▼
                     ┌───────────────┐    ┌───────────────┐
                     │  Zen Models   │    │  Kai Models   │
                     │ (LLM / Reason)│    │ (Decision Mod)│
                     └───────────────┘    └───────┬───────┘
                                                  │
                                                  ▼
                                          ┌───────────────┐
                                          │Typed Decision │
                                          │    Package    │
└───────────────┘- Zen : les modèles génératifs de frontière de Hanzo, faits pour raisonner. Utilisez Zen quand vous avez besoin de recherche textuelle profonde, de preuves par chaîne de pensée en plusieurs étapes, de synthèse créative et de rédaction de documents.
- Kai : la famille de modèles de décision à poids ouverts de Hanzo. Utilisez Kai quand vous avez besoin d'un routage déterministe, d'une sélection d'outils, de seuils de sûreté, d'une exécution d'ordres, d'un triage et du contrôle de la boucle de l'agent.
- Enso : le méta-routeur à haut débit qui inspecte les tâches entrantes à la couche de la microseconde, envoie les tâches génératives à Zen et les tâches de décision à Kai.
Poids ouverts. Infrastructure souveraine.
Une infrastructure de décision fiable ne peut pas rester enfermée dans une API tierce fermée qui change de comportement sans préavis. Quand un modèle gouverne des déploiements de production, des systèmes physiques ou un risque financier, vous devez avoir une souveraineté complète sur ses poids, son exécution et la confidentialité des données.
Kai 1 est à poids ouverts. Vous pouvez l'exécuter :
- Sur le cloud souverain de Hanzo : à l'échelle mondiale, avec des garanties d'egress nul et des latences inférieures à la milliseconde.
- Dans votre propre VPC ou sur site : déployable avec Docker ou Kubernetes, sur des GPU NVIDIA, AMD ROCm ou des nœuds CPU à haute densité.
- En périphérie : entièrement déconnecté, pour la robotique, l'aérospatial et les environnements de défense souveraine.
Cessez de demander aux modèles de langage d'écrire des dissertations quand votre logiciel a seulement besoin d'une décision.
Bienvenue dans l'ère de l'intelligence de décision.
Des décisions, pas des complétions
Exécutez Kai dès aujourd'hui via la Hanzo Cloud API, ou téléchargez les poids ouverts pour déployer des modèles de décision calibrés dans votre infrastructure souveraine.
Lire la suite
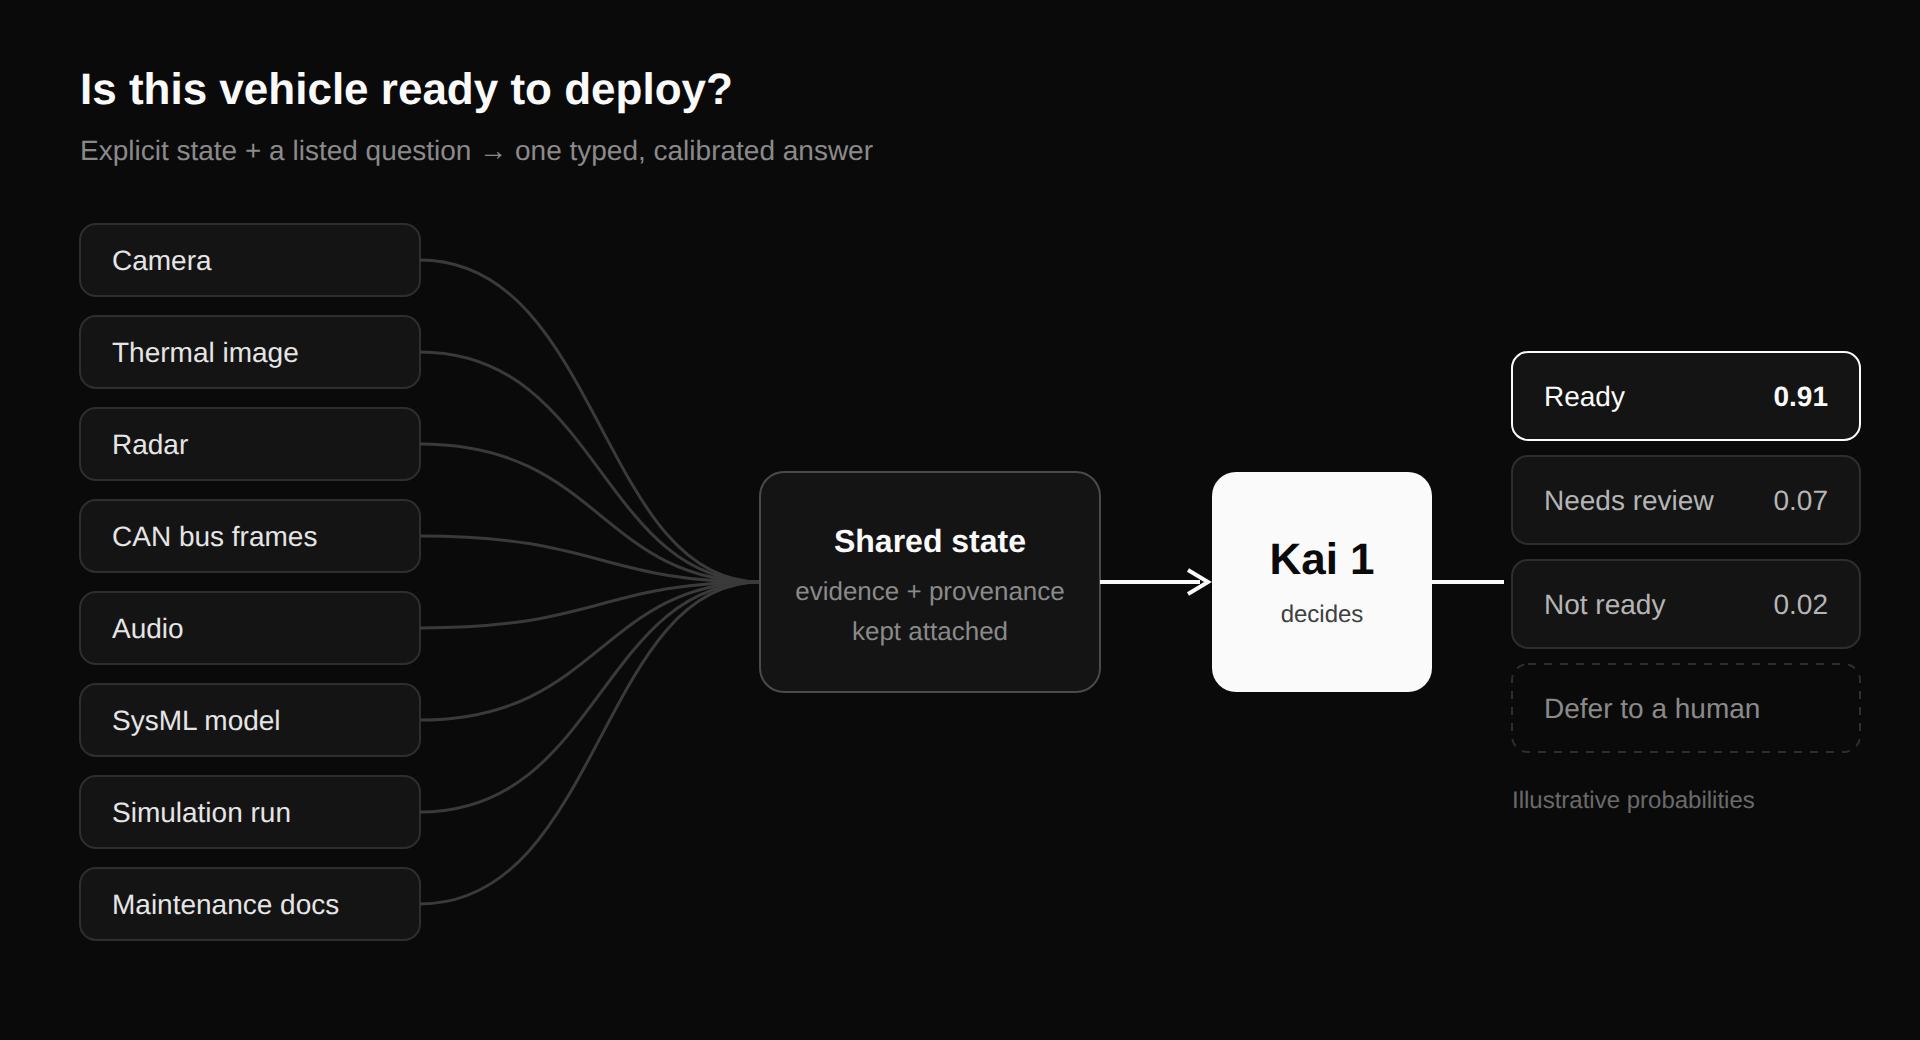
Kai 1 : des décisions, pas des complétions
Kai est le modèle de décision de Hanzo, servi par la Hanzo API. Donnez-lui un état explicite et une question aux options énumérées : il renvoie une réponse typée et calibrée, un choix, un score, un oui ou un non, ou un renvoi argumenté.
Rendre le commerce headless lisible à l'ère des LLM agentiques
Les acheteurs deviennent des agents. Ce qu'il faut pour être lisible, signable et payable par un LLM sans humain dans la boucle, et ce que Hanzo livre aujourd'hui.
Votre IA prévoit de vous tuer
Pourquoi les modèles frontières échouent quand des vies réelles sont en jeu, et comment Hanzo Kai 1.9 impose une sûreté déterministe.